1. 改造输出层
逻辑回归也可以通过 multinomial/softmax 形式在一个模型中完成多分类,不必总是使用一对多。神经网络可以直接在一个模型内完成。
做法
- 需要分几类,输出层就设几个神经元
- 每个神经元输出一个 [0,1] 的值,代表样本属于该类别的概率
例如三分类:
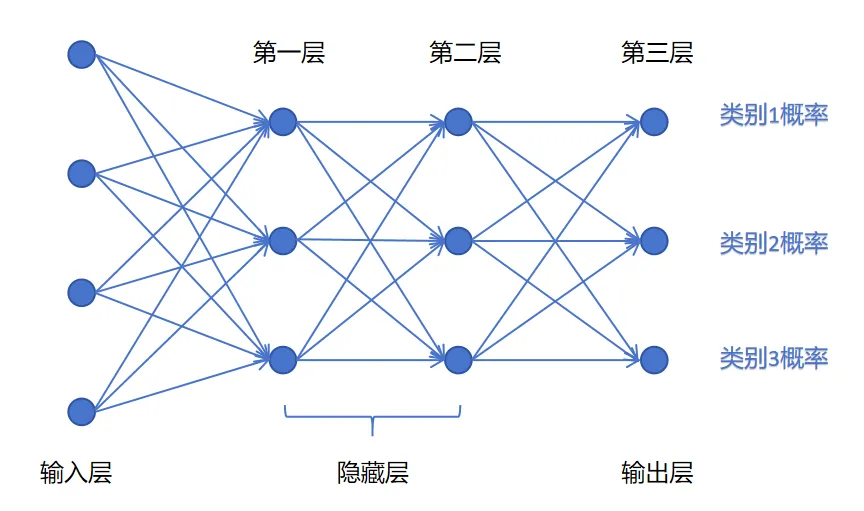
输入层 → 隐藏层 → 输出层(3个神经元)
                        ↓
                   [0.05, 0.90, 0.05]  → 属于第 2 类
Logits
输出层经过线性变换、还没有经过激活函数的值,称为 logits。logits 经过激活函数后才变成最终的概率输出。
2. Softmax 激活函数
2.1 一个朴素想法的问题
想让输出变成概率,最直接的想法:每个神经元的 logits 除以所有 logits 之和。
两个问题:
| 问题 | 原因 |
|---|---|
| 概率可能为负 | logits 有正有负,直接除,负值得到负概率 |
| 不同类别差异是线性的 | [2, 2, 5] 归一化 → [0.22, 0.22, 0.56],差异不够大,训练慢 |
2.2 Softmax 解法
两步:先取指数,再归一化。
三分类示例(3 个 logits ,输出概率 ):
2.3 通用公式
个类别,第 个类别的概率:
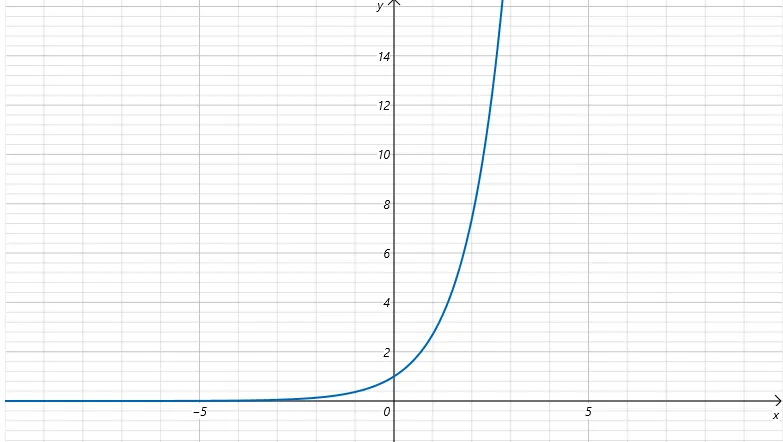
2.4 Softmax 的两个优势
优势一:解决负值问题
永远是正数 → 所有分子分母为正 → 输出概率永远在 (0, 1) 之间且为正。
优势二:放大差异,加速训练
的指数增长,将微小的 logits 差异非线性放大:
| 方法 | [2, 2, 5] 的结果 |
|---|---|
| 直接归一化 | [0.22, 0.22, 0.56] — 差异平缓 |
| Softmax | [0.045, 0.045, 0.909] — 差异明显 |
类别 3 的概率从 0.56 被拉到了 0.91,模型”更自信”了。这给出一个有效的可微概率映射,不保证训练更快;过于尖锐的 softmax 也可能产生饱和。实际计算应减去最大 logit,或直接使用框架的稳定实现。
3. 多分类交叉熵损失
3.1 从二分类 BCE 到多分类 CE
二分类 BCE:
多分类的交叉熵是它的自然推广。
3.2 设定
- 类别数 =
- 真实标签用独热(one-hot)向量:,只有真实类别对应位置为 1,其余为 0
- 预测概率分布:,是 Softmax 输出,满足
3.3 公式
单个样本:
由于 one-hot 中只有一个是 1,上式展开后只剩一项:
其中 是模型对真实类别给出的预测概率。
- → loss = 0(完全正确)
- → loss (完全错误,重罚)
3.4 批量样本
batch size = :
4. 多分类 vs 二分类的输出层设计
| 输出神经元数 | 激活函数 | 损失函数 | |
|---|---|---|---|
| 二分类 | 1 个 | Sigmoid | BCELoss |
| 二分类(备选) | 2 个 | 训练直接传 logits | CrossEntropyLoss |
| 多分类 | C 个 | 训练直接传 logits | CrossEntropyLoss |
二分类也可以用 2 个输出神经元 + Softmax。但实践中更常用 1 个神经元 + Sigmoid,参数更少,效率更高。
5. 总结
多分类神经网络的完整数据流:

输入 X
  ↓
隐藏层(线性变换 + ReLU)
  ↓
输出层(线性变换)→ logits(未激活的原始值)
  ↓
Softmax → 概率分布(和 = 1,每项在 (0,1))
  ↓
训练:CrossEntropyLoss 直接接收 logits,常用 long 类型类别索引
推理:对 logits 做 Softmax 得到概率
  ↓
梯度反向传播 → 更新所有层参数

关键理解:
  Softmax 的指数运算 = 解决正负问题 + 放大类间差异
  交叉熵 = 只看真实类别对应的预测概率,越接近 1 越好
对于单 logit 二分类,通常优先使用 BCEWithLogitsLoss,训练前不再手动 sigmoid。多标签问题与互斥多分类不同,通常是每类独立 logit 配合二元交叉熵。