1. 激活函数的核心作用:引入非线性
1.1 没有激活函数会怎样?
以一个简单网络为例:1 个隐藏层(2 个神经元)+ 1 个输出层(1 个神经元),没有激活函数。
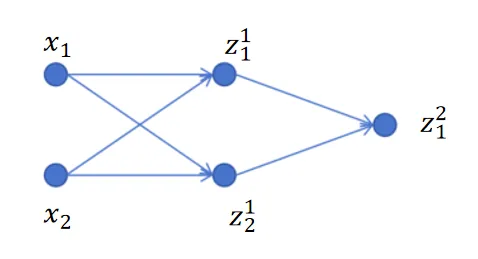
隐藏层输出(纯线性):
输出层:
1.2 代入消元
把 和 代入 的表达式,展开合并:
所有 w 和 b 可以组合成新的系数:
1.3 结论
不管有多少层,如果没有激活函数,最终可合并为单个仿射映射(前提是中间只有仿射层)。
堆叠层数的意义完全消失。激活函数就是那个打破这个等价关系的关键——在每层线性变换之后加一个非线性函数。
激活函数模拟了生物神经元的”抑制”和”激活”行为,为网络表达非线性关系提供条件;可逼近的函数范围还取决于网络容量、激活、输入域与误差标准,不意味着任何有限网络都能精确表示任意函数。
2. Sigmoid
公式
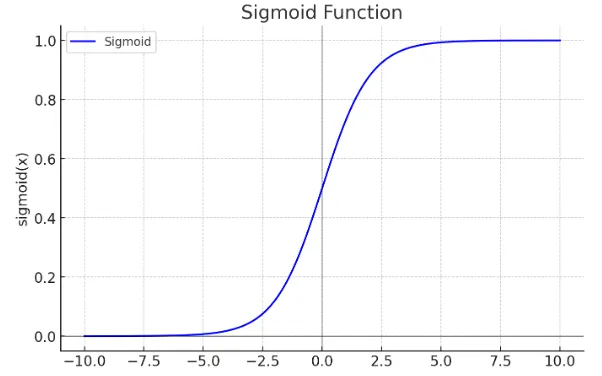
特点
| 属性 | 值 |
|---|---|
| 输出范围 | (0, 1) |
| 优点 | 天然映射到概率,可解释性强 |
| 缺点 | 两端梯度趋近 0(梯度消失),输出不以 0 为中心 |
适用场景
二分类问题的输出层(最后一个神经元),将输出转为概率。隐藏层中已基本被 ReLU 替代。
3. Tanh(双曲正切)
公式
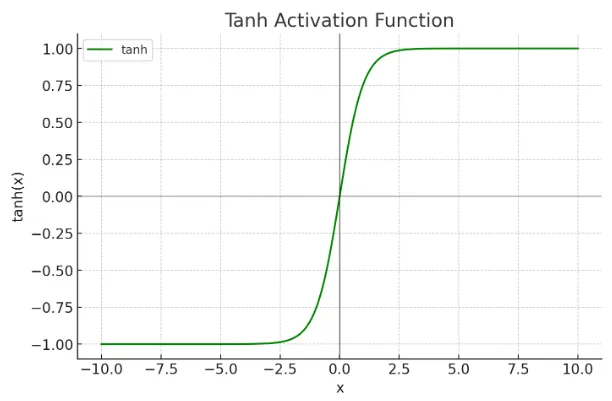
特点
| 属性 | 值 |
|---|---|
| 输出范围 | (-1, 1) |
| 与 Sigmoid 的关系 | ,是 Sigmoid 的缩放平移版 |
| 优点 | 输出以 0 为中心,比 Sigmoid 更利于下一层的学习 |
| 缺点 | 同样存在两端梯度消失的问题 |
适用场景
历史上曾在隐藏层中使用较多。现在除特定场景(如 RNN / LSTM 内部)外,多数已被 ReLU 替代。
4. ReLU(Rectified Linear Unit)
公式
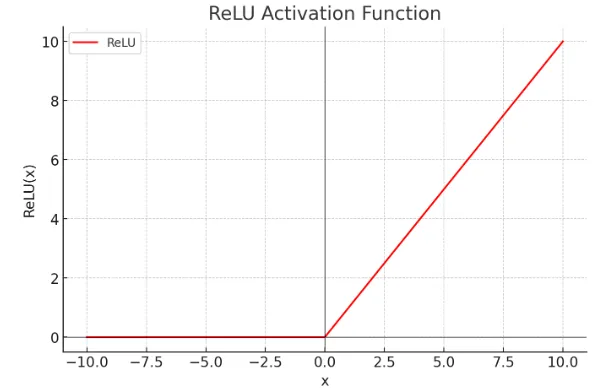
特点
| 属性 | 值 |
|---|---|
| 输出范围 | [0, +∞) |
| x > 0 时 | 输出 = x,梯度 = 1(没有梯度消失) |
| x ≤ 0 时 | 输出 = 0,梯度 = 0 |
为什么 ReLU 是深度学习默认选择
- 计算极简单:只是一个 max 操作,没有指数运算,前向和反向都极快
- 缓解梯度消失:正半轴梯度恒为 1,深层网络也能有效传递梯度
- 稀疏激活:负半轴输出为 0,意味着网络中只有一部分神经元在”工作”,类似生物神经系统的稀疏激活特性
缺点
一次前向中输入小于 0,该 ReLU 路径的梯度为 0;若一个单元对所有相关训练输入都长期处于非正区间,它才可能持续得不到该路径的梯度,称为“死亡 ReLU”。单次负输入不代表参数永远不更新,其他路径或权重衰减也可能改变参数。
5. Leaky ReLU
公式
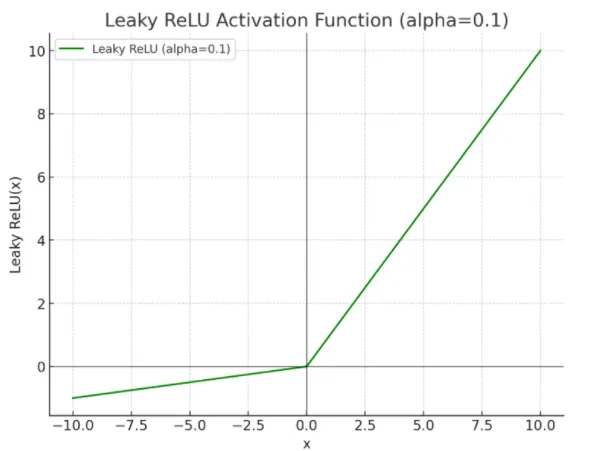 通常取一个很小的值,如 0.01 或 0.1。
解决的问题
ReLU 在 x ≤ 0 时梯度为零 → 神经元可能永久死亡。Leaky ReLU 在负半轴给一个微小的斜率 ,使负半轴的局部导数非零,但上游梯度仍可能为零,不能保证参数每次都更新。
| ReLU | Leaky ReLU | |
|---|---|---|
| x > 0 | 梯度 = 1 | 梯度 = 1 |
| x ≤ 0 | 梯度 = 0(死亡) | 梯度 = (微弱但非零) |
6. 总结
激活函数的作用:在线性变换后引入非线性
    没有它 → 多层 = 一层
    有了它 → 网络可以拟合任意复杂函数

四种激活函数对比:

    Sigmoid       → (0, 1)    → 二分类输出层专用
    Tanh           → (-1, 1)  → 以 0 为中心,历史常用
    ReLU           → [0, +∞)  → 当前默认选择,简单高效
    Leaky ReLU     → (-∞, +∞) → 修复 ReLU 神经元死亡问题

选择原则:
    隐藏层   → 默认用 ReLU(或其变体 Leaky ReLU)
    输出层   → 二分类用 Sigmoid,多分类用 Softmax(后文会讲),回归用恒等映射