1. 标准梯度下降的两个问题
1.1 振荡 — 到不了最优点
当不同参数的梯度量级差异大时,会发生:
参数 b:梯度大,正负交替,来回振荡
参数 w:梯度小,稳步下降
结果:b 方向上反复横跳,模型无法精确收敛到最优点,永远在周围"画圈"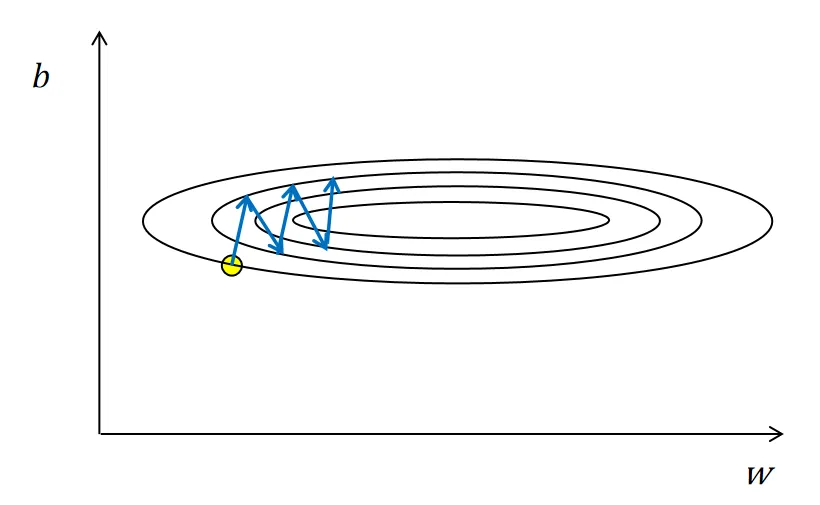 等高线图上的表现:黄点出发,在 b 方向上来回弹跳,沿着 w 方向缓慢下降。
1.2 局部最优 — 卡住了
当某个参数的梯度在一个局部区域接近 0 时,标准梯度下降对该参数的更新几乎停滞,陷在局部最优解出不来。
2. 动量梯度下降的核心思想
不用当前梯度的值来更新参数,而是用梯度的指数加权平均值。
2.1 怎么解决振荡
振荡时,b 的梯度正负交替。经过指数加权平均:
- 正的 + 负的 → 部分抵消 → 振荡幅度大幅减小
- w 方向梯度始终同号 → 平均后保持一致性 → 下降方向更纯粹
→ 震荡被抑制,模型平稳逼近最优点。
2.2 怎么解决局部最优
指数加权平均考虑了历史梯度:
- 当前位置梯度 = 0(局部最优)
- 但历史累积的梯度不为 0
- 非零历史动量可使参数继续前进;是否越过该区域取决于学习率和动量,不能保证逃离任意局部最优
2.3 物理直觉
小球从山顶滚下来(物理动量)
  ├── 因为有惯性 → 摇晃被平滑,方向越来越一致
  ├── 遇到小坑(局部最优) → 靠惯性冲过去
└── 有机会越过浅区域,但不保证找到全局最优一句话:抑制振荡,惯性加速。
3. 更新公式
3.1 对每个参数
以参数 为例:
第一步:计算梯度
第二步:更新梯度的指数加权平均值
第三步:用 更新参数(而非用原始梯度 )
3.2 标准梯度下降 vs 动量梯度下降
| 标准梯度下降 | 动量梯度下降 | |
|---|---|---|
| 更新依据 | (当前梯度) | (梯度指数加权平均) |
| 振荡 | 严重(正负交替) | 被平滑(正负抵消) |
| 局部最优 | 容易卡住 | 靠惯性冲过去 |
| 额外存储 | 无 | 每个参数一个 |
3.3 超参数
- 一般取 0.9
- (学习率)仍需设置
- 不需要偏差修正(Adam 中才需要,后面会讲)
4. 在 PyTorch 中使用
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)momentum=0.9 对应 ,但 PyTorch 默认的动量缓冲递推为 (首步初始化为 ),不含本文指数平均中的 因子。因此两种约定的相同数值学习率不能直接等同;需结合递推约定和初始条件调整学习率。
5. 总结
标准梯度下降的问题:
  ├── 不同参数梯度量级不同 → 振荡
  └── 梯度为 0 的局部点 → 卡住

动量解法:
  V = β·V + (1-β)·g       ← 用指数加权平均替代原始梯度
  w = w - lr·V             ← 沿平滑后的方向更新

效果:
  ├── 正负振荡相互抵消 → 训练更稳定
  ├── 历史梯度给你惯性 → 冲过局部最优
  └── β = 0.9 几乎成了默认配置

PyTorch:optim.SGD(params, lr=0.01, momentum=0.9)
接口对照
- PyTorch SGD:动量缓冲、初始化与学习率约定。