神经网络
在深度学习的神经网络里,一般按层进行划分。整体上神经网络会被分为输入层,隐藏层,和输出层。输入层就是原始特征,输出层就神经网络最终的输出。除了输入层和输出层,剩下的层都是隐藏层。
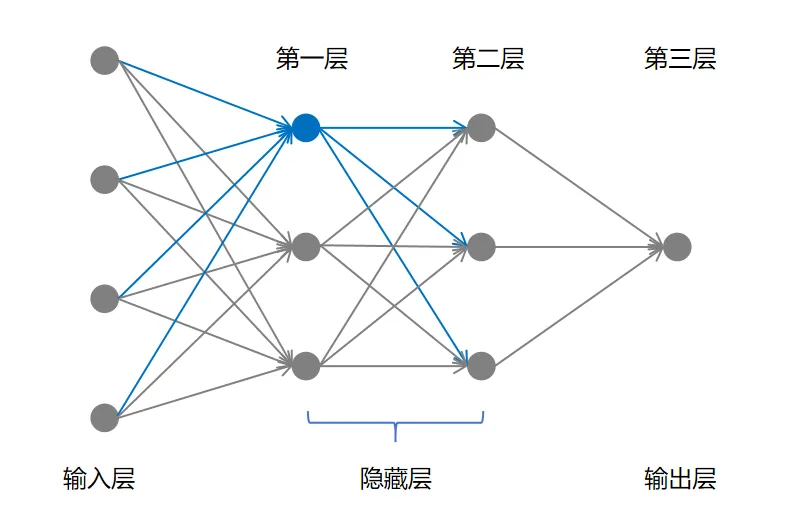
这里讨论全连接网络。nn.Linear 只实现仿射变换,激活函数是独立操作;神经网络也可以包含卷积、注意力、归一化等其他类型的层。或者叫做全连接层、稠密层(Dense Layer),因为每一层的每个神经元都和前一层的每个神经元进行连接,所以叫做全连接、稠密连接。
神经网络与矩阵计算
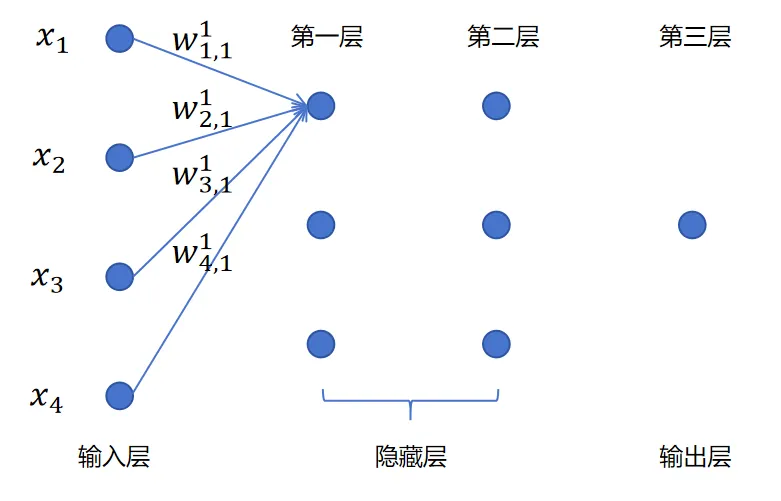
解释:
- x1,x2,x3,x4是一个样本的4个特征值,也就是输入层的输入。
- w1,11表示一个权重值
- 上标1,表示这是第一层的参数。
- 下标(1,1),
- 第一个1表示这是针对第一个输入的权重。
- 第二个1表示这是第一层的第1个神经元。
w1,11表示第一层的第一个神经元对第一个输入的权重参数。
第一层第一个神经元线性计算
z11=[x1, x2, x3, x4]w1,11w2,11w3,11w4,11
第一层第二个神经元线性计算
z21=[x1, x2, x3, x4]w1,21w2,21w3,21w4,21
第一层第三个神经元线性计算
z31=[x1, x2, x3, x4]w1,31w2,31w3,31w4,31
一层全部神经元合并矩阵形式
z1=[z11, z21, z31]=[x1, x2, x3, x4]w1,11w2,11w3,11w4,11w1,21w2,21w3,21w4,21w1,31w2,31w3,31w4,31
批量样本矩阵运算
[x11x21x12x22x13x23x14x24]w1,11w2,11w3,11w4,11w1,21w2,21w3,21w4,21w1,31w2,31w3,31w4,31
z1=[z11, z21, z31],可以给线性回归结果加上偏置值 [b11, b21, b31]。
b21 表示第一层第二个神经元的偏置值。
z1=[z11, z21, z31]+[b11, b21, b31]
对每个元素应用sigmoid函数就得到了第1层的激活值:
a1=sigmoid([z11, z21, z31])
a1 成为神经网络第二层的输入,第二层的计算可以用矩阵运算完成。
z2=[z12, z22, z32]=[a11, a21, a31]w1,12w2,12w3,12w1,22w2,22w3,22w1,32w2,32w3,32
激活函数
激活函数的作用是引入非线性。
如果没有激活函数,不论有几层线性回归,最终都等价于一层的线性回归。
引入激活函数,模拟大脑神经元里的抑制和激活。神经网络才可以拟合任意函数。
- sigmoid(x)=1+e−x1
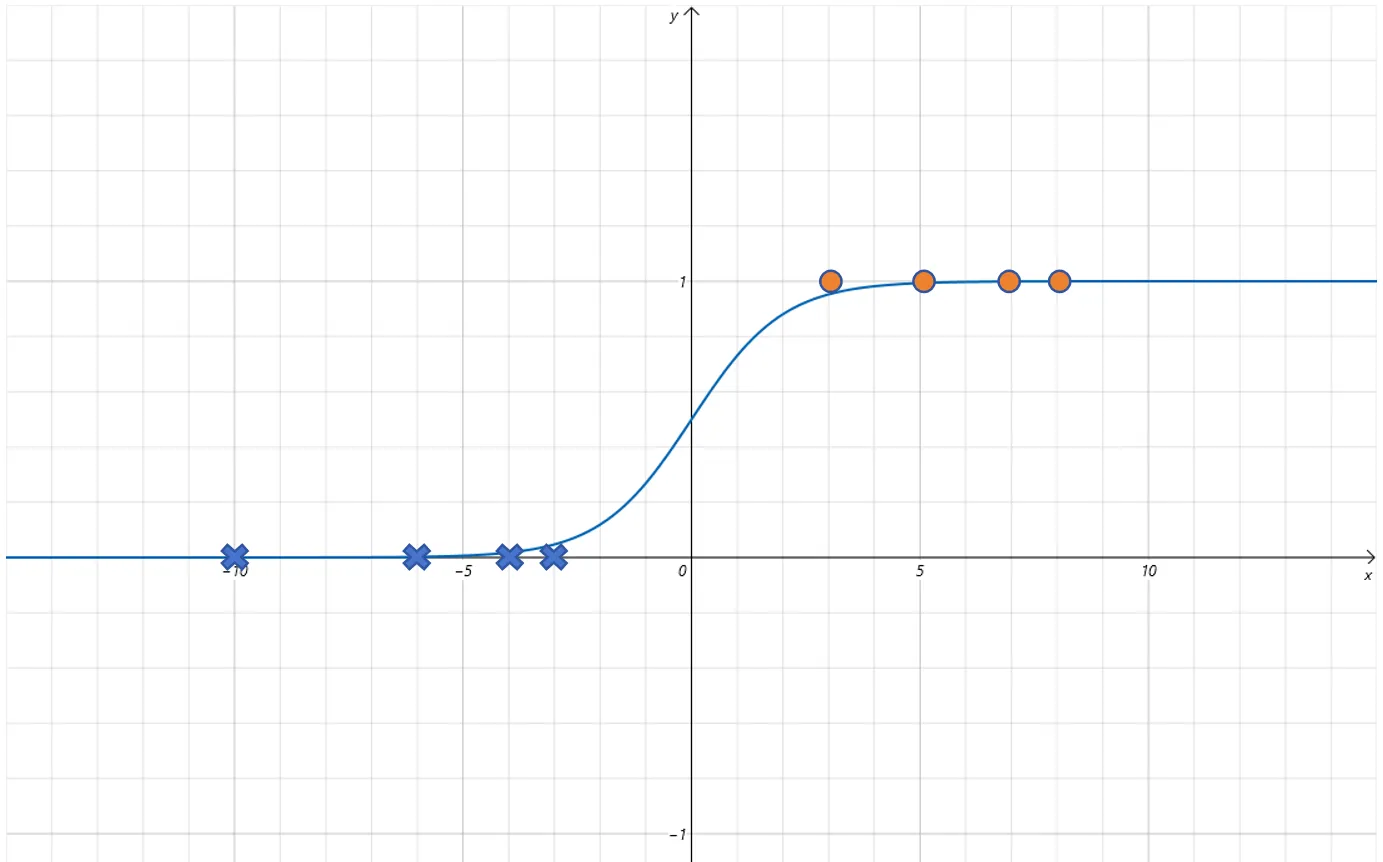
可以将x映射到0到1之间。
好处:
0-1自然映射到概率值范围。
它非常适合作为二分类问题的神经网络的最后一层唯一神经元的激活函数。
- tanh(x)=ex+e−xex−e−x
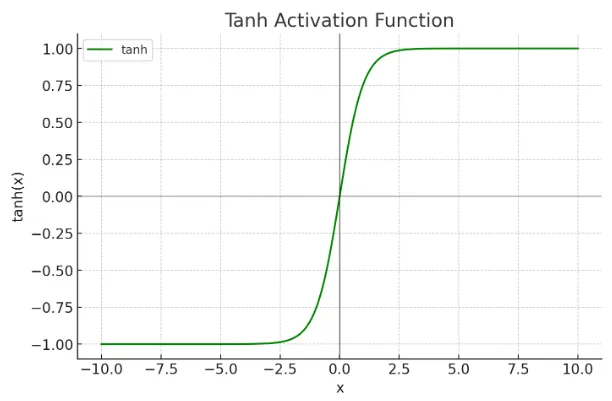
- ReLU(x)=max(x,0)
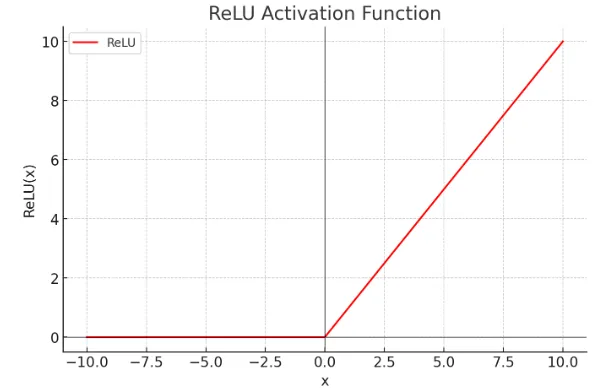
当输入当x>0 时,输出为 x;当输入 x≤0 时,输出为 0。
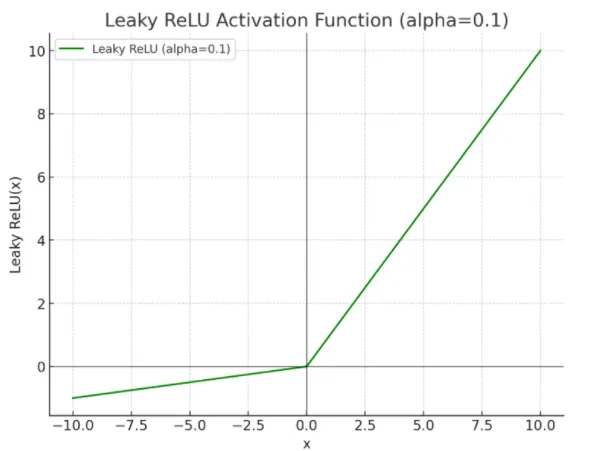
- Leaky ReLU:
- 当x>0时: LeakyReLU(x)=x
- 当x≤0时: LeakyReLU(x)=αx
其中αα一般取小于1的数,比如0.1。这样当x取负值是也会有一个微小的梯度,可以更新参数。
神经网络的多分类
名词解释:
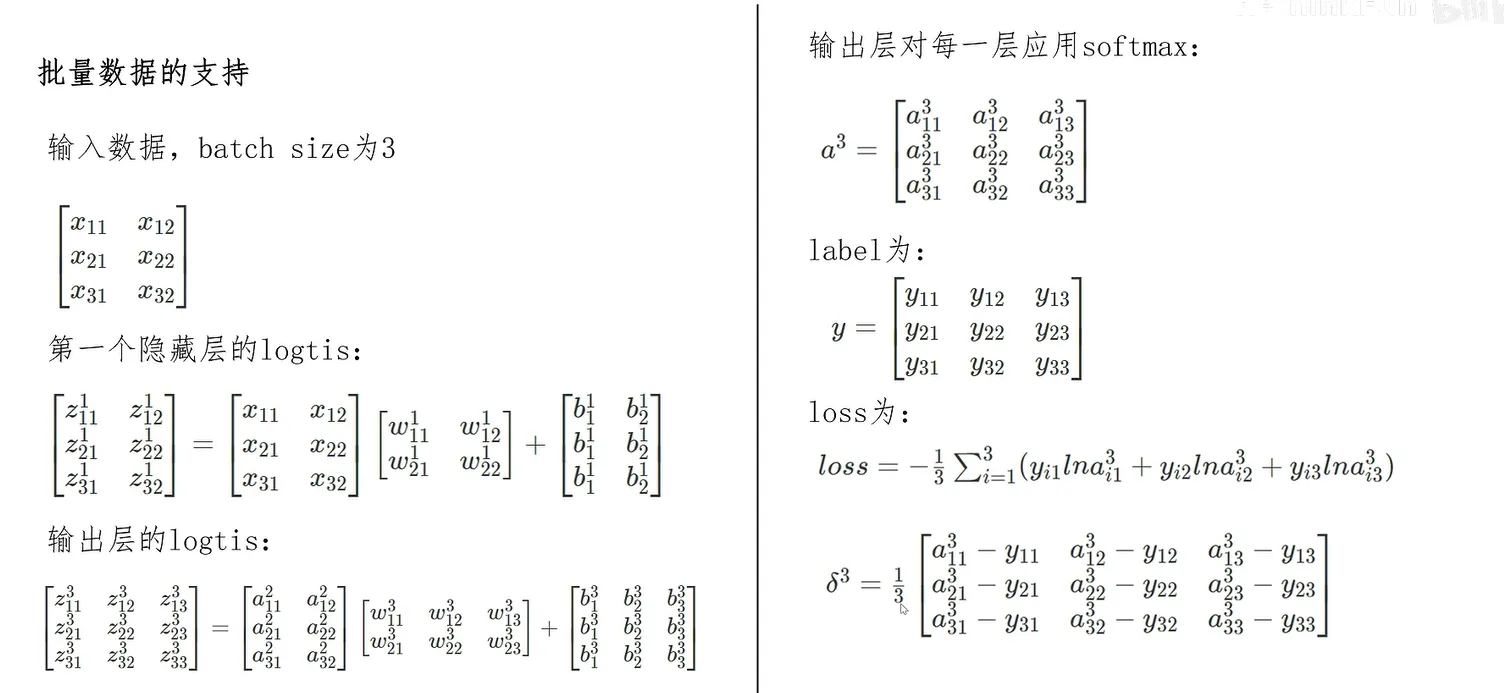
对于神经网络,输出层经过线性回归,还没有经过激活函数的值,叫做logits。logits经过激活函数后就是最终的输出值
激活函数的选择
希望神经网络最后一层的logtis经过激活函数后可以代表样本属于每个类别的概率值。既然是概率值,则要求它们的和为1。
错误想法:
用每个神经元logits的值,除以所有神经元logits值的和作为最终的概率
- logits的值有正有负,这样得到每个神经元的激活值,也就是概率值可能为负。
- 这样做对不同类别的差异是线性的,我们希望能放大不同类别的差异,加速训练过程。
-
softmax函数
我们假设输出层3个神经元的logits值为z1,z2,z3,经过softmax输出的概率值为O1,O2,O3,
softmax函数的计算公式如下:
O1=ez1+ez2+ez3ez1
O2=ez1+ez2+ez3ez2
O3=ez1+ez2+ez3ez3
然后我们给出通用的softmax的公式:假设这个分类问题有n个类别,也就是输出层有n个神经元,输出的logits值有n个。
对于第i个logits值输出的概率值,通过softmax计算公式如下:
Oi=ez1+ez2+⋯+eznezi
-
交叉熵损失函数
假设如下:
- 类别个数为C。
- 真实标签用one-hot向量表示:y=(y1,y2,…,yC),其中y是一个样本的标签值,它的值是一个向量,有C个元素,里边只有一个元素yi=1,代表这个样本的真实类别,其余值都为0。
- 预测的概率分布是:p=(p1,p2,…,pC),其中p是这个样本经过神经网络的softmax激活输出,它的值是一个向量,有C个元素,这C个元素因为是softmax的输出,代表概率,满足∑i=1Cpi=1。
交叉熵损失定义为: loss=−∑i=1Cyilog(pi)
对于一个具体的样本,由于yi只有一个为1,其余都为0,可以简化为:
loss=−log(py)
其中py是模型对真实类别y的预测概率。如果样本的真实类别为2,则这个样本的损失值就为loss=−log(p2),当p2等于1时(预测类别和真实类别一致),loss为0。当p2越接近0,loss越接近无穷大。
如果是对于批量样本计算loss,batch size 是N,则总的交叉熵损失就为:
loss=−N1∑n=1N∑i=1Cyinlog(pin)
多分类神经网络的反向传播
网络结构
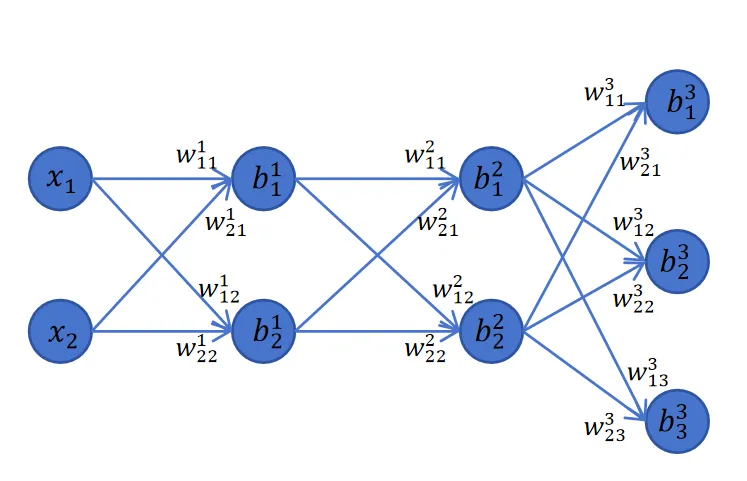
- 输入:2 个特征 x₁, x₂
- 隐藏层 1:2 个神经元,权重矩阵 W¹ (2×2),偏置 b¹ (1×2)
- 隐藏层 2:2 个神经元,权重矩阵 W² (2×2),偏置 b² (1×2)
- 输出层:3 个神经元(对应 3 个类别),权重矩阵 W³ (2×3),偏置 b³ (1×3)
- 激活函数:act() 可选 Sigmoid、ReLU、Tanh 等
- 最终输出:经过 Softmax 得到概率分布
符号约定:
- zᵏᵢ:第 k 层第 i 个神经元的 logits(激活前的值)
- aᵏᵢ:第 k 层第 i 个神经元的激活值
- wᵏᵢⱼ:第 k 层从第 j 个输入到第 i 个输出的权重
前向传播过程
输入: [x1x2]
第一个隐藏层的logits: [z11z21]=[x1x2][w1,11w2,11w1,21w2,21]+[b11b21]
第一个隐藏层的输出如下。其中act()是激活函数,对logits的值逐个应用激活函数:
[a11a21]=[act(z11)act(z21)]
第一个隐藏层的输出作为第二个隐藏层的输入,则第二个隐藏层的logits为:
[z12z22]=[a11a21][w1,12w2,12w1,22w2,22]+[b12b22]
第二个隐藏层的输出:
[a12a22]=[act(z12)act(z22)]
输出层的logits:
[z13z23z33]=[a12a22][w1,13w2,13w1,23w2,23w1,33w2,33]+[b13b23b33]
输出层经过softmax得到神经网络的输出:
Softmax — 把 logits 变成概率分布
Softmax(zi)=∑jezjezi
# 例如:
z = [2.0, 1.0, 0.1]
e^z = [7.389, 2.718, 1.105]
sum = 11.212
softmax(z) = [0.659, 0.242, 0.099]   # 三个值加起来 = 1
[y^1y^2y^3]=[Softmax(z13)Softmax(z23)Softmax(z33)]
a3=[a13a23a33],ai3=∑j=13ezj3ezi3
网络输出结果和标签值利用交叉熵损失函数来计算loss:真实标签用一维的one-hot向量表示:
y=[y1y2y3]
其中向量y的元素中只有一个元素为1,其余元素为0。则交叉熵loss公式为:
对于多分类问题,损失函数是交叉熵损失:
L=−c=1∑Cyc⋅ln(y^c)
其中:
- C = 类别数(本例中 C=3)
- y_c = 真实标签的 one-hot 编码(正确类别为 1,其余为 0)
- ŷ_c = 模型预测的第 c 类的 Softmax 概率
例子:真实标签是类别 0,模型预测的概率为 [0.7, 0.2, 0.1]
y_true = [1, 0, 0]         # one-hot 编码
y_pred = [0.7, 0.2, 0.1]   # softmax 输出

Loss = -(1·ln(0.7) + 0·ln(0.2) + 0·ln(0.1))
     = -ln(0.7)
     = 0.357               # 预测越准,Loss 越小
loss=−(y1lna13+y2lna23+y3lna33)
反向传播过程— 输出层梯度推导
神经网络里每层的权重和偏置都可以看成是一个由多个参数构成的矩阵。反向传播时需要计算每个权重和偏置的梯度,实际上就是用最终的loss值对每一个参数求导,这些对单个参数的求导计算可以通过矩阵运算进行加速。
反向传播的核心思想:链式法则从输出层向前逐层计算梯度。
loss对logits求导
∂zi3∂loss=ai3−yi(i=1,2,3)
δ3=[a13−y1a23−y2a33−y3]
Softmax + 交叉熵组合的梯度特别简单:预测概率 - 真实标签。
具体看推导过程
输出层的logits计算公式如下:
[z13z23z33]=[a12a22][w113w213w123w223w133w233]+[b13b23b33]
下边分别**求loss对每一个 wij3 的梯度。 **
我们以loss对 w113 的偏导数为例: ∂w113∂loss=∂z13∂loss⋅∂w113∂z13+∂z23∂loss⋅∂w113∂z23+∂z33∂loss⋅∂w113∂z33
因为其中只有 z13 和 w113 有关,上边连加表达式的后两项 z23,z33 对 w113 求导都为0,
所以有: ∂w113∂loss=∂z13∂loss⋅∂w113∂z13
其中 ∂z13∂loss 等于 δ13,而 z13=a12×w113+a22×w213+b13,所以 ∂w113∂z13 的结果为 a12。
最终结果为: ∂w113∂loss=δ13a12
依次类推,我们可以求出每个 wij3 的梯度
[δ13a12δ13a22δ23a12δ23a22δ33a12δ33a22]
可以用矩阵运算表示如下:
∂w3∂loss=(a2)Tδ3=[a12a22][δ13δ23δ33]
偏置的梯度值
以loss对b13的偏导为例:
loss对b13求偏导,因为只有b13只和z13有关,所以:
∂b13∂loss=∂z13∂loss⋅∂b13∂z13
其中∂z13∂loss为δ13,又因为z13=a12×w113+a22×w213+b13,所以∂b13∂z13就等于1。
最终结果为:
∂b13∂loss=∂z13∂loss⋅∂b13∂z13=δ13
同理,loss对b23,b33的偏导为:δ23,δ33,所以loss对于第三层偏置的偏导就等于δ3。
计算loss对于第二层参数的偏导数
利用链式法则,通过a2进行传递,所以下边先计算loss对于a2的偏导数。
我们以loss对a12为例:
∂a12∂loss=∂z13∂loss⋅∂a12∂z13+∂z23∂loss⋅∂a12∂z23+∂z33∂loss⋅∂a12∂z33=δ13w113+δ23w123+δ33w133
同理,可以得到:
∂a22∂loss=δ13w213+δ23w223+δ33w233
改为矩阵表示loss对第二层激活值的偏导为:
∂a2∂loss=δ3(w3)T=[δ13δ23δ33]w113w123w133w213w223w233
接求loss对第二层logits值的偏导:
δ2=∂z2∂loss=∂a2∂loss⋅∂z2∂a2=δ3(w3)T⊙act′(z2)
其中⊙是矩阵对应元素相乘(哈达玛积),因为激活函数是对每个z值单独应用的,所以这里求导也是逐个元素应用的。
第二层的梯度
与上边对输出层的权重和偏置的求导方法一样,我们可以得到:
∂w2∂loss=(a1)Tδ2
loss对于第二层偏置的偏导就等于δ2。
loss对于第一层logits值的偏导为:
δ1=δ2(w2)T⊙act′(z1)
第一层的梯度
loss对于第一层权重的偏导为:
∂w1∂loss=xTδ1
loss对于第一层偏置的偏导就等于δ1
假设这个神经网络一共有n层,第n层是输出层。
x是输入向量,y是one-hot的label向量。
则:
δn=an−y
对于第i层而言:
δi=δi+1(wi+1)T⊙act′(zi)
∂wi∂loss=(ai−1)Tδi
∂bi∂loss=δi
第一层的输入是x:
a0=x