先修知识
阅读本文前,建议先理解:
1. 问题根源:链式法则中的连乘
1.1 展开看第一层权重的梯度
以之前 3 层网络为例,第一层权重的梯度为:
把 逐层展开:
1.2 层数变深的后果
如果是 100 层网络,第一层权重的梯度中包含:
- 99 个激活函数导数值连乘
- 99 个权重矩阵连乘
连乘的性质:
| 乘数 | 100 个连乘的结果 |
|---|---|
| 全部 = 0.7 | → 梯度消失,参数几乎不更新 |
| 全部 = 1.5 | → 梯度爆炸,参数剧烈震荡 |
梯度消失和梯度爆炸是深度神经网络训练的头号障碍。
2. 应对一:选对激活函数
梯度公式里连乘了 ,所以激活函数的导数值范围至关重要。
2.1 Sigmoid — 不适合隐藏层
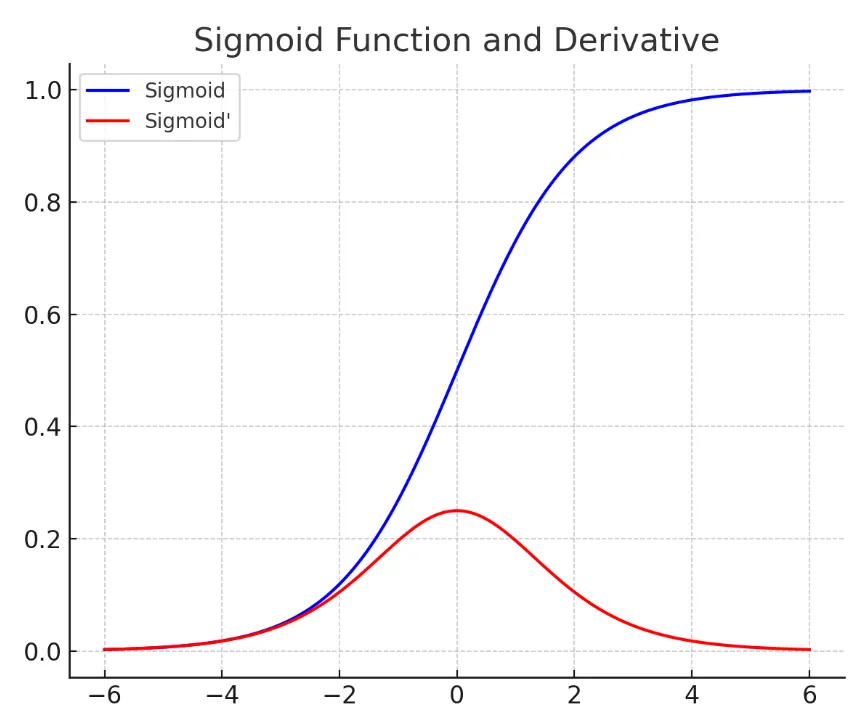
| 属性 | 值 |
|---|---|
| 导函数取值范围 | (0, 0.25] |
| 最大值 | 仅 0.25,且只在 处取得 |
多个 sigmoid 的局部导数可能使梯度衰减,但完整 Jacobian 还包含权重矩阵,不能只由导数上界推出必然梯度消失。
结论:深层前馈网络的隐藏层通常避免大量使用 sigmoid,但 LSTM 等门控结构仍会使用它;并非只能用于二分类输出层。
2.2 Tanh — 比 Sigmoid 好,但仍有问题
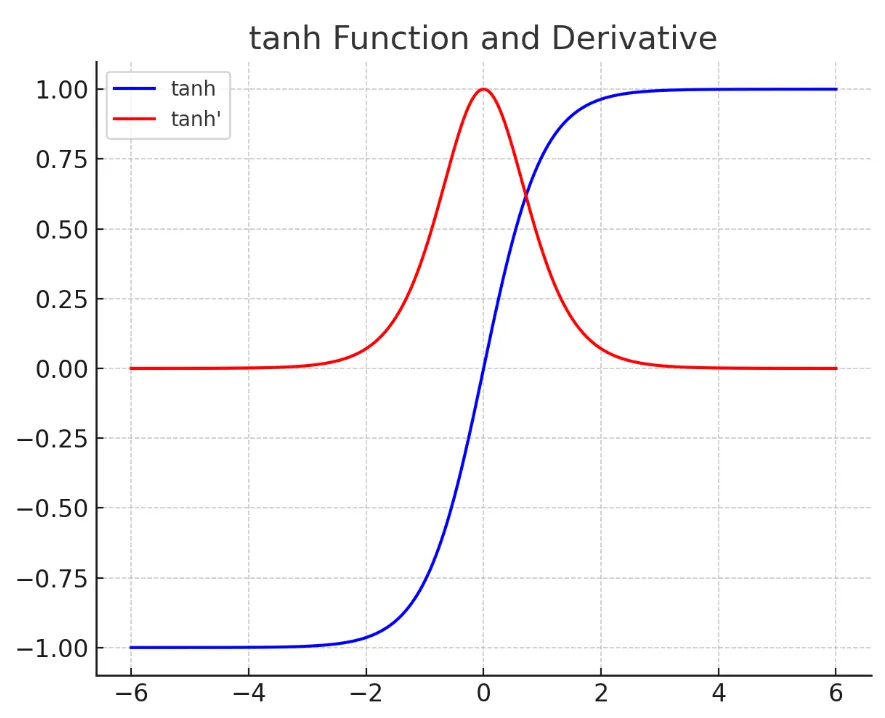
| 属性 | 值 |
|---|---|
| 导函数取值范围 | (0, 1] |
| 饱和区 | $ |
比 Sigmoid 好(导数上限高),但输入的绝对值稍微大一点就进入饱和区,导数仍接近于 0。
2.3 ReLU — 深度学习默认选择
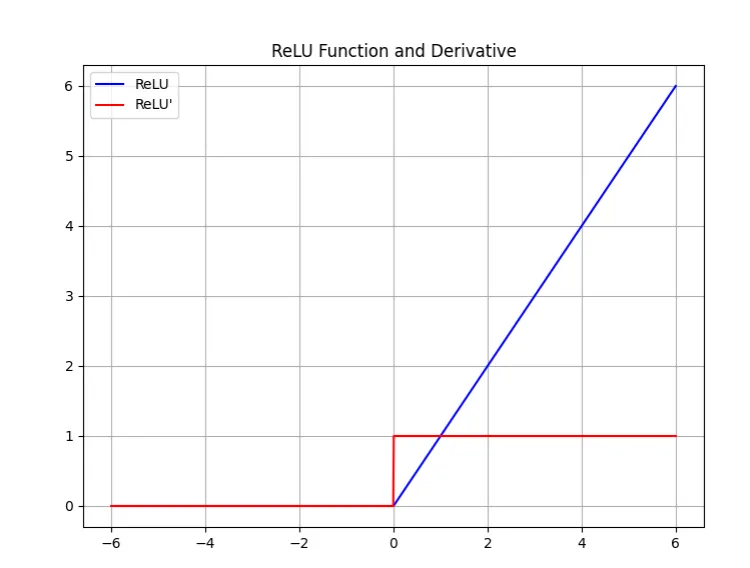
| 属性 | 值 |
|---|---|
| 时导数 | 恒为 1 |
| 时导数 | 0(神经元抑制) |
导数为 1 意味着——正半轴上梯度在传播时不会被缩放,这一局部导数不缩小梯度;权重矩阵、非激活通路等因素仍可能导致整体梯度消失或爆炸。
这是 ReLU 能支持深层网络训练的根本原因。
3. 应对二:正确的参数初始化
梯度公式里还连乘了权重 。权重初始化不当,同样会导致梯度消失或爆炸。
3.1 必须随机初始化 — 打破对称性
如果同一层的所有神经元参数初始化为相同值:
- 它们的输入相同、输出相同
- 反向传播的梯度也相同
- 每次更新后依然相同
- 多个神经元退化成一个神经元
初始化必须随机,让不同神经元学到不同的特征。
3.2 控制方差 — Kaiming 初始化
假设输入已标准化(均值 0,方差 1)。
问题:一层有 个输入,每个是”输入 × 权重”的累加 → 输出的方差会被放大为 倍。层数一多,方差逐层膨胀或收缩。
再加上 ReLU 大约让一半神经元输出为 0,方差应修正为 。
为了保持每层输出的方差稳定,需要将权重初始化为:
其中 是该层输入的数量(即上一层的神经元数)。这就是 Kaiming 初始化(也叫 He 初始化)。
| 激活函数 | 推荐初始化 | 标准差 |
|---|---|---|
| ReLU | Kaiming (He) | |
| Tanh / Sigmoid | Xavier (Glorot) | , 取决于激活约定 |
PyTorch 层会执行默认初始化,但它不一定是针对后续 ReLU 的 He 正态初始化。要复现上述标准差,应明确调用 nn.init.kaiming_normal_;相关细节见 PyTorch 初始化。
4. 其他方法(后续会讲到)
除了激活函数和初始化,还有其他缓解梯度消失/爆炸的技术:
| 方法 | 简述 |
|---|---|
| 批量归一化(Batch Normalization) | 在每层内部对输出做标准化,保证数值稳定 |
| 残差连接(Residual Connection) | 给梯度提供一条”高速公路”,跳过中间层直接往前传 |
5. 总结
问题:链式法则导致前层梯度 = 大量导数连乘
     ├── 每项 < 1  → 梯度消失(深层参数几乎不更新)
     └── 每项 > 1  → 梯度爆炸(参数震荡发散)

三大应对:
     ├── 激活函数   → ReLU(正半轴导数 = 1,不衰减)
     ├── 参数初始化 → 随机 + Kaiming(方差 √(2/n))
     └── (后续)     → 批量归一化、残差连接

为什么 ReLU 能支持深层网络:
    Sigmoid 导数 ≤ 0.25  → 10 层后梯度 ≈ 0
    ReLU 正半轴导数 = 1  → 100 层后梯度依然在