先修知识
阅读本文前,建议先理解:
1. 从特征图到分类结果
卷积层和池化层的输出,是带有空间位置信息的特征图。要完成分类,还需要最后一步:
多通道特征图 → Flatten(展平成一维向量)→ 全连接层 → 分类- 经过足够多的卷积后,特征图已经是概括性的高级特征
- 全连接层在高级特征(而非原始像素)上做分类
- 卷积负责”提取特征”,全连接负责”汇总决策”
2. 各模块的职责
| 模块 | 作用 |
|---|---|
| 卷积层 | 用多个 Filter 滑动提取局部特征,每个 Filter 输出一个通道 |
| 激活函数 | 引入非线性(最常用 ReLU) |
| 池化层 | 提取最强特征、缩小尺寸(下采样) |
| Flatten | 把多维特征图展平成一维向量 |
| 全连接层 | 汇总特征,完成分类/回归 |
| Dropout | 防过拟合(一般用在全连接层) |
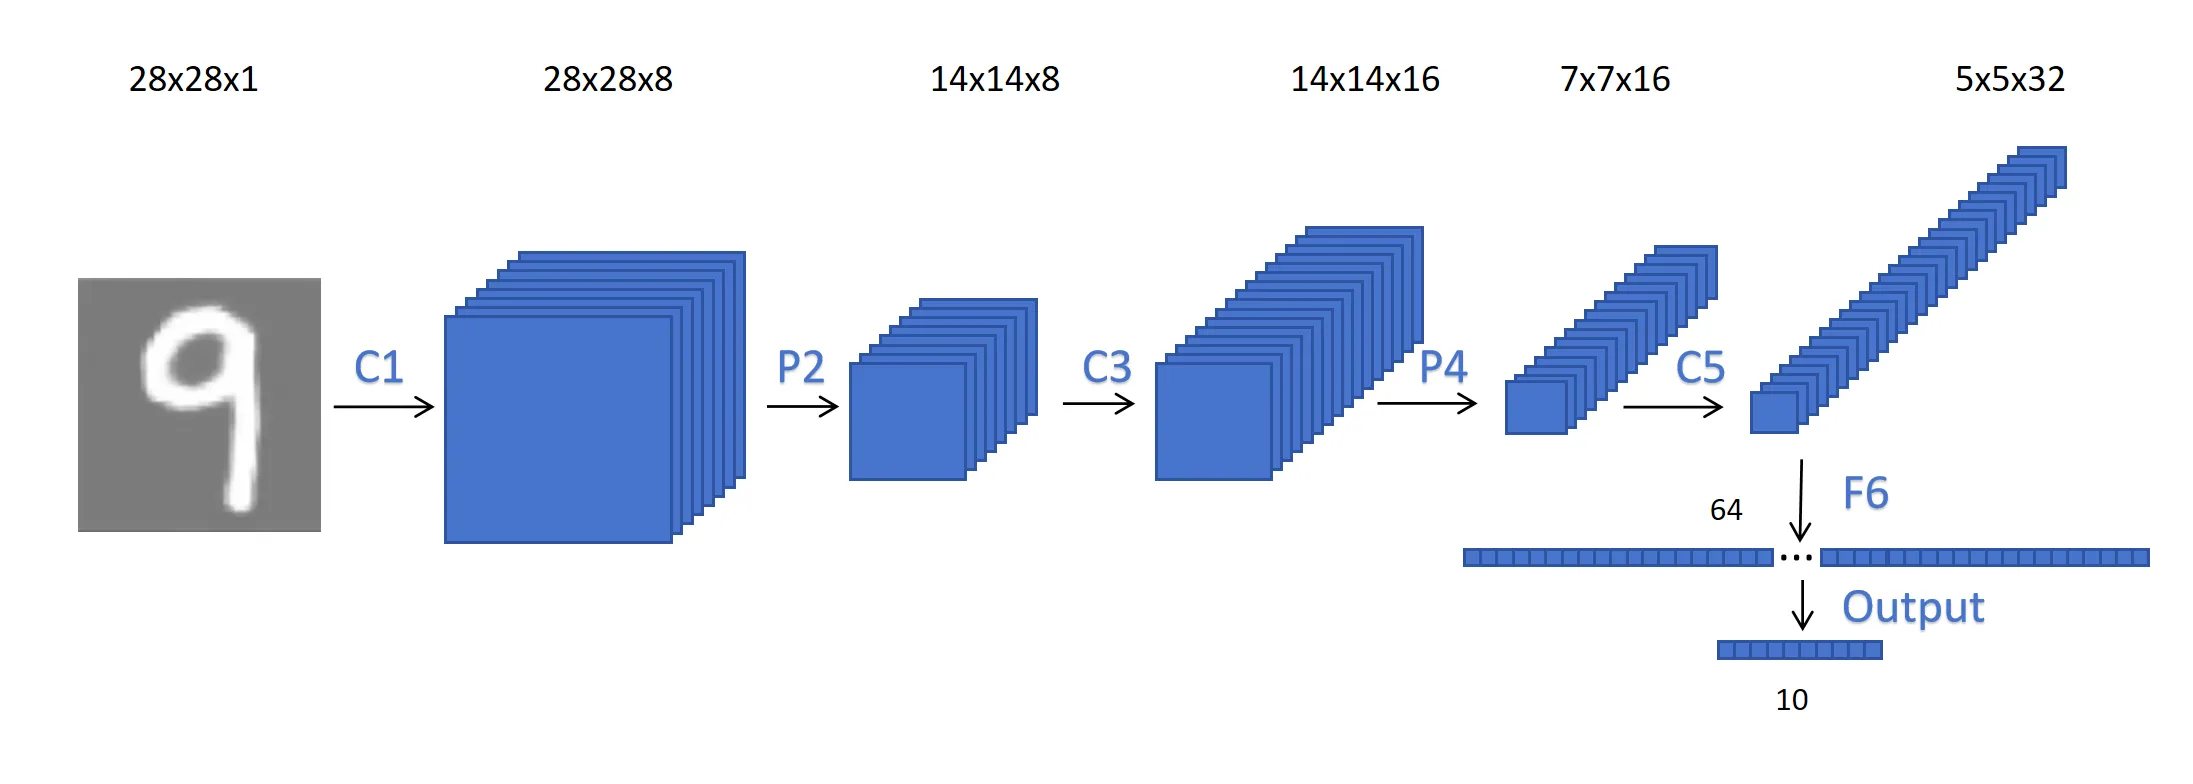
3. 一个完整的 CNN 示例(手写数字识别)
3.1 网络结构
| 层 | 类型 | 参数 | 输出尺寸 |
|---|---|---|---|
| 输入 | 灰度图 | — | 28×28×1 |
| C1 | 卷积(8 个 3×3,P=1,S=1)+ ReLU | 见下 | 28×28×8 |
| P2 | 最大池化(2×2,S=2) | 0 | 14×14×8 |
| C3 | 卷积(16 个 3×3,P=1,S=1)+ ReLU | 见下 | 14×14×16 |
| P4 | 最大池化(2×2,S=2) | 0 | 7×7×16 |
| C5 | 卷积(32 个 3×3,P=0,S=1)+ ReLU | 见下 | 5×5×32 |
| Flatten | 展平 | 0 | 1×800 |
| F6 | 全连接(800→64)+ ReLU | 见下 | 64 |
| 输出 | 全连接(64→10)+ Softmax | 见下 | 10 |
3.2 逐层参数计算
| 层 | 单个 Filter 参数 | Filter 数 | 总参数 |
|---|---|---|---|
| C1 | 3×3×1 + 1 = 10 | 8 | 80 |
| C3 | 3×3×8 + 1 = 73 | 16 | 1,168 |
| C5 | 3×3×16 + 1 = 145 | 32 | 4,640 |
| F6 | 800×64 + 64 | — | 51,264 |
| 输出层 | 64×10 + 10 | — | 650 |
3.3 关键发现
- 池化层参数量 = 0
- 全连接层 F6 占了全部参数约 88.7%(51264 / 57802)
这也是为什么现代 CNN(如 ResNet)倾向于用全局平均池化替代最后的全连接层,以减少参数。
4. 结构规律:尺寸缩小,通道增多
观察上面的网络:
特征图尺寸:28 → 14 → 7 → 5  (越来越小)
通道数:    1  → 8  → 16 → 32 (越来越多)
为什么这样设计?
| 浅层 | 深层 | |
|---|---|---|
| 感受野 | 小 | 大 |
| 特征类型 | 边缘、纹理等低级特征 | 五官、表情等高级语义 |
| 对位置 | 敏感(需要大特征图精确定位) | 不敏感(小特征图即可) |
| 通道数 | 少 | 多(编码更多潜在高级特征) |
规律:低级特征感受野小、对位置敏感 → 需要大的特征图 + 少的通道;高级特征感受野大、对位置不敏感 → 小的特征图 + 多的通道。
5. 总结
完整 CNN = 卷积层 + 激活 + 池化层 + ... + Flatten + 全连接层

数据流:
  原始图(28×28×1)
    → 卷积+ReLU(提取特征,尺寸不变/略缩)
    → 池化(最强特征,长宽减半)
    → 重复若干次
    → Flatten(展平)
    → 全连接(分类)

结构规律:
  尺寸 ↓(越来越小),通道 ↑(越来越多)
  卷积层学特征,全连接层做决策

参数分布:
  全连接层占大头(本例 88%)
  → 现代网络常用全局平均池化替代