1. Dropout 的核心思想
训练时随机”关掉”一部分神经元,每次训练的都是一个简化版的网络。
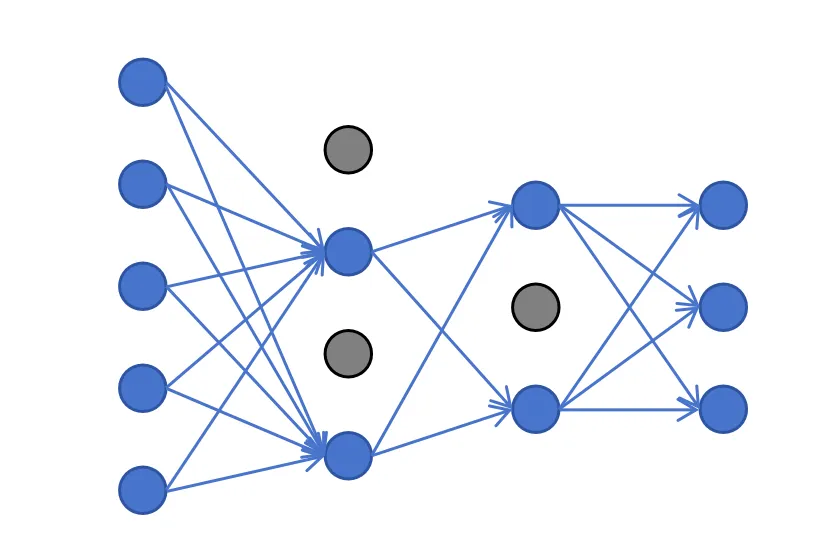
效果:每个神经元不能依赖特定同伴的存在,必须学到独立有用的特征。
类比:一个团队如果总是靠某几个明星成员才能出成果,这个团队不健康。Dropout 随机让一些人”请假”,逼着每个人都要有独立战斗力。
2. 训练阶段
2.1 随机禁用
以超参数 的概率随机禁用隐藏层的某些神经元:
- 被丢弃的激活元素:输出置零,本次该路径的梯度也为零
- 保留的神经元:正常工作
每次前向传播,被禁用的神经元都不一样。
2.2 缩放:为什么除以
保留神经元的输出需要除以 :
原因:确保下一层接收到的输入的期望值不变。
- 训练时:只有 比例的神经元在工作,总输入会变小
- 除以 :补偿这种变小,让期望值和没有 Dropout 时保持一致
这使每个激活在随机掩码下的期望保持一致,并不保证方差、完整分布或后续非线性网络的输出都相同。这里采用 PyTorch 的 inverted dropout,。
3. 推理阶段
预测时 Dropout 不起作用,所有神经元都参与计算。
训练时:随机关神经元 + 缩放 → 每个 batch 训练不同子网络
推理时:全部神经元在线    → 综合所有子网络的能力
可直观理解为训练许多共享权重的子网络;关闭 dropout 后的单次前向通常只是集成效果的近似,并不严格等于所有子网络预测的算术平均。
model.train() vs model.eval()
model.train()   # 启用 Dropout(训练模式)
# ... 训练代码 ...

model.eval()    # 关闭 Dropout(推理模式)
# ... 预测代码 ...一定要正确切换,否则推理时 Dropout 还开着,结果会出错。
4. Dropout 为什么有效 —— 防止神经元共适应
| 没有 Dropout | 有 Dropout |
|---|---|
| 某些神经元组成了”小团体”互相依赖 | 每个神经元不能依赖同伴 |
| 神经网络只是在训练数据上记住了特定组合 | 每个神经元学到独立、通用的特征 |
| 换个数据集可能就失效 | 泛化能力更好 |
5. 使用注意事项
| 注意事项 | 说明 |
|---|---|
| 常用于隐藏表示,也可用于输入 | 是否对输入使用取决于任务;通常不直接随机丢弃最终预测 logits |
| 一般取 0.1 ~ 0.5 | 越大正则化越强。较大网络可用较大的 |
| 训练/推理行为不同 | 必须正确使用 model.train() / model.eval() |
6. PyTorch 实现
import torch.nn as nn

class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.model = nn.Sequential(
            nn.Linear(28*28, 128),
            nn.ReLU(),
            nn.Dropout(0.5),          # 每次随机丢弃 50% 神经元
            nn.Linear(128, 128),
            nn.ReLU(),
            nn.Dropout(0.5),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Dropout(0.5),
            nn.Linear(64, 10)
        )

    def forward(self, x):
        return self.model(x.flatten(1))
7. 正则化方法小结
过拟合 → 模型在训练集上过度学习,泛化差

三种解决路线:
  ├── L1/L2 正则化 / 权重衰减 → 约束参数,不让参数太大
  ├── Dropout                   → 约束结构,随机禁用神经元
  └── 早停 (Early Stopping)     → 约束训练时长,在过拟合前停下

它们可以组合使用,效果叠加。
8. 总结
Dropout = 训练时随机关神经元 + 除以 (1-p) 缩放

训练:
  每个 batch 随机丢弃比例为 p 的神经元
  保留神经元输出 ÷ (1-p),维持期望不变
  等价于每次训练一个不同的子网络

推理:
  所有神经元都工作
  可理解为共享权重的子网络集成近似

PyTorch:
  nn.Dropout(p=0.5)     ← 加在 Linear 和 ReLU 之间
  model.train()          ← 训练前调用
  model.eval()           ← 推理前调用