逻辑回归
一元逻辑回归
逻辑回归是一个分类问题的算法。
用Sigmoid函数拟合二分类问题。
Sigmoid函数:
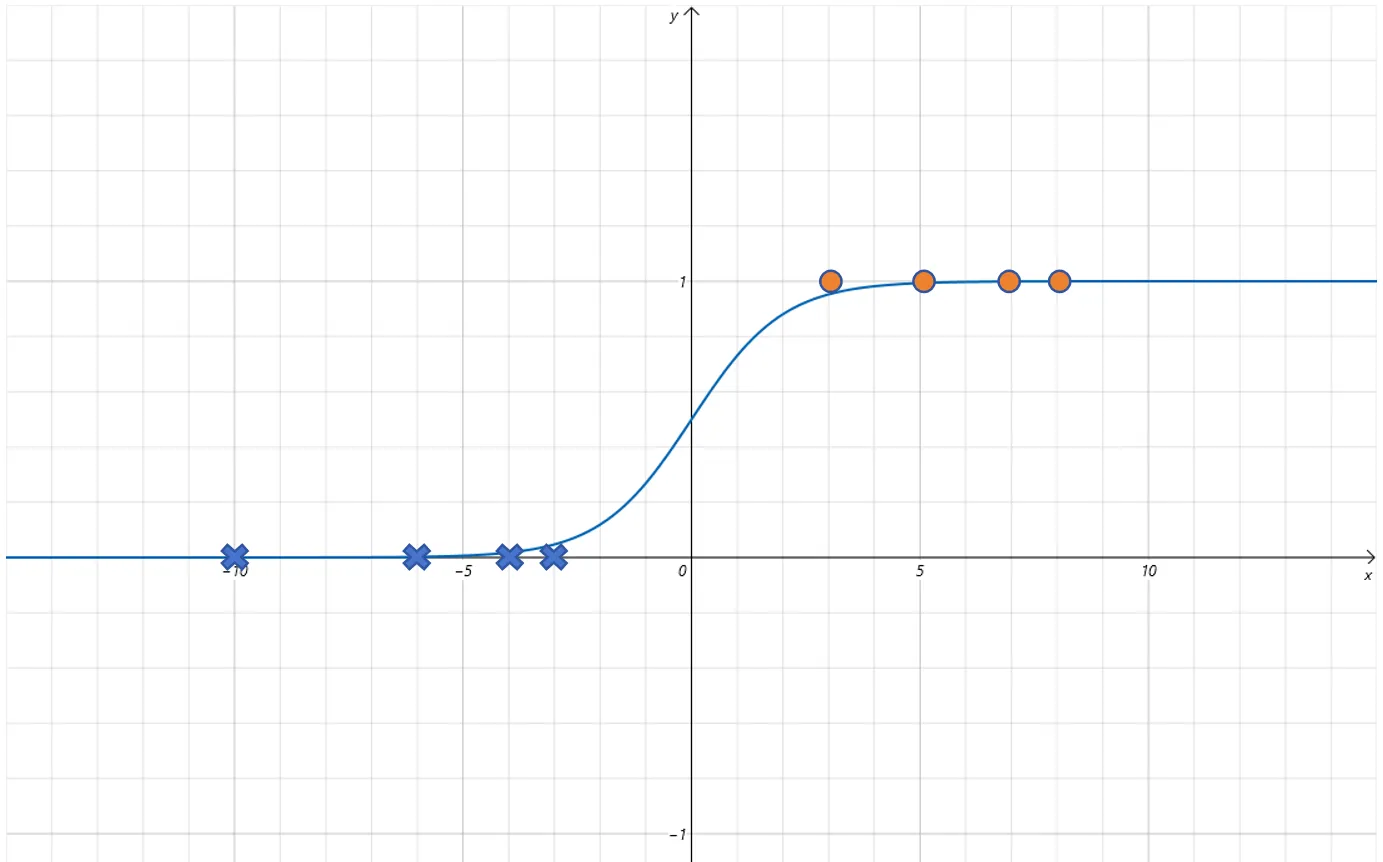
Sigmoid函数有很好的特性,它的输出值区间为[0,1],而且只有x取值在0附近时,函数值有明显的变化,其他区间都很非常接近0或者1。
用Sigmoid函数可以很好的作为二分类问题的假设函数。线性回归的假设函数为线性方程,它假设Feature和Label之间满足线性关系。而二分类问题的假设函数就为Sigmoid,它假设输入x和输出y之间满足Sigmoid函数的映射关系。
给Sigmoid函数增加缩放参数
实际上,直接利用Sigmoid函数拟合的也不是很好。我们可以给Sigmoid函数里的前边增加一个参数。
给Sigmoid函数增加平移参数
当需要对Sigmoid函数进行平移才可以拟合这些点时,我们可以给Sigmoid函数再增加一个参数。
一元逻辑回归的假设函数
其中的和参数会对标准的Sigmoid函数曲线进行平移、翻转、缩放等,最终将输出映射到。
理解:
对Sigmoid函数的输入x,增加了w和b参数。实际上就是对x应用了一个线性回归,然后再进行Sigmoid变化。
可以理解为一元逻辑回归就是在线性回归的基础上,增加了一个Sigmoid函数。这个Sigmoid函数叫做激活函数。
在深度学习里,输入首先经过一个线性变化,然后经过一个非线性的函数,比如这里的Sigmoid函数。
这个非线性的函数我们就叫做激活函数。激活函数的作用就是在线性函数的基础上增加了非线性。
Sigmoid函数是我们学习的第一个激活函数。它在输入小于0的时候,对输出产生抑制作用,输出接近于0;当输入大于0时,产生激活作用,输出快速接近1。
总结:
Sigmoid这个激活函数的作用可以将大于0的数快速映射到接近1,小于0的数快速映射到接近0。
在逻辑回归里,Sigmoid函数的输入是线性回归的结果,所以线性回归的作用,就是将Feature通过参数w和b的线性变化,让正例的线性变化结果大于0,让负例的线性变化结果小于0。再由Sigmoid函数将线性回归的结果映射到0-1之间。
逻辑回归损失函数
训练一个模型,就需要定义损失函数,然后利用梯度下降算法,让损失越来越小。最终得到让损失最小的模型参数。
预测就是利用训练好的模型参数和新采集的Feature,带入假设函数,预测一个输出。
交叉熵损失函数
我们用表示Label值,用表示预测值。 则二分类交叉熵损失函数BCELoss(Binary Cross Entropy Loss)分为两种情况。
分别是当时:
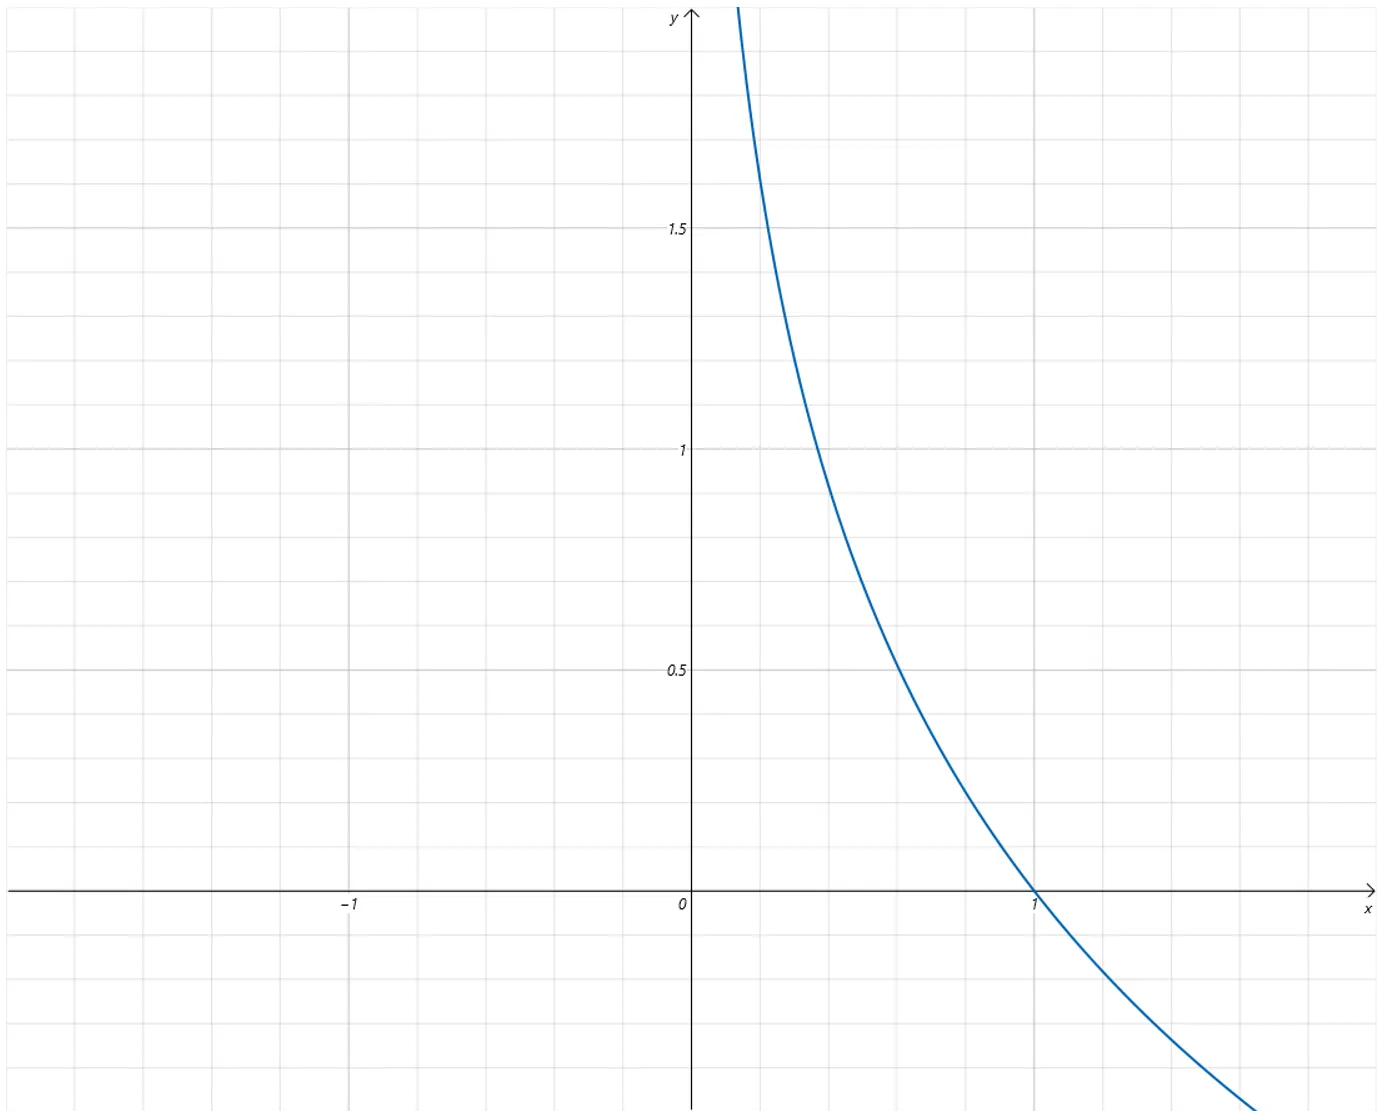
因为Label值为1,预测值为Sigmoid函数的输出,取值为从0到1。从Loss曲线可以看到,当预测值越接近0,Loss值越大,越接近1,Loss值越小。当预测值和Label相等,等于1时,Loss值为0。
当时:
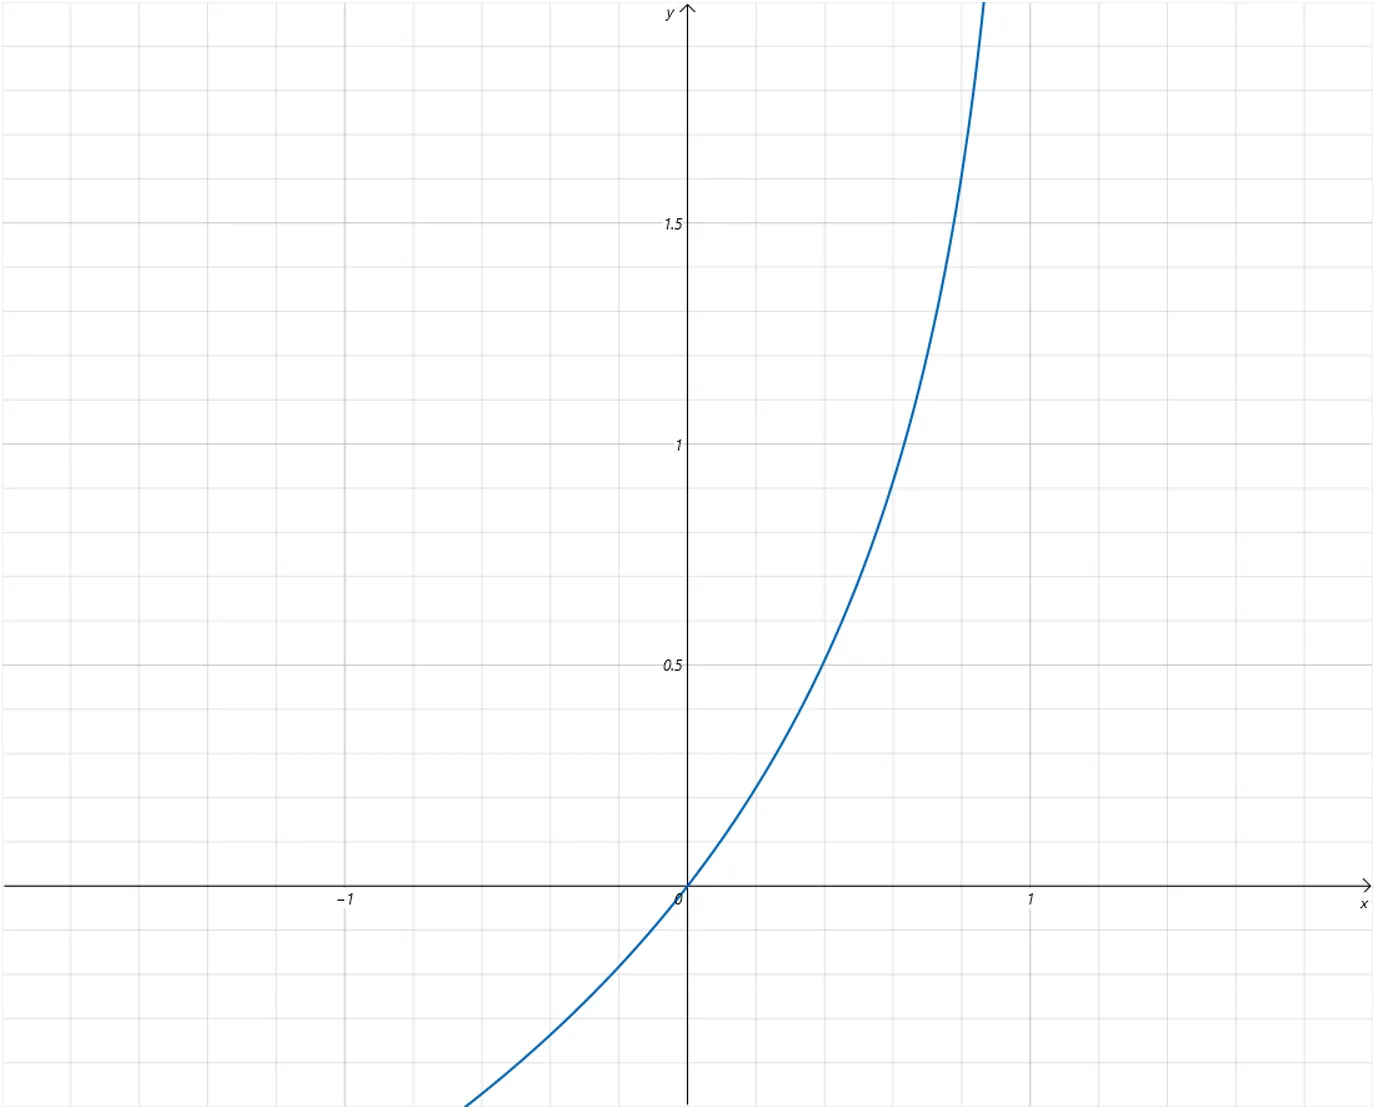
因为Label值为0,预测值为Sigmoid函数的输出,取值为从0到1。从Loss曲线可以看到,当预测值越接近1,Loss值越大,越接近0,Loss值越小。当预测值和Label相等,等于0时,Loss值为0。
BCELoss需要分情况来写,比较麻烦,我们将它们统一到一个式子里:
多元逻辑回归
多元逻辑回归,就是将一元逻辑回归中的一元线性回归部分,升级为多元线性回归。然后还是对线性回归的结果应用Sigmoid激活函数。
多元逻辑回归中,多元线性回归部分,将多个Feature通过对应的参数以及进行线性变化,让正例的多元线性变化结果大于0,让负例的多元线性变化结果小于0。最后同样由Sigmoid函数将线性回归的结果映射到0和1之间。
逻辑回归也是可以用来多分类的,最常用的方法,就是1对多方式。
假如要分类的类别为A,B,C,D。
你可以训练4个逻辑回归的模型,它们分别为:
区分A和其他(B,C,D)的二分类模型。以A为正例,Label为1。
区分B和其他(A,C,D)的二分类模型。以B为正例,Label为1。
区分C和其他(A,B,D)的二分类模型。以C为正例,Label为1。
区分D和其他(A,B,C)的二分类模型。以D正例,Label为1。
在预测时,把样本的feature分别输入4个逻辑回归的模型,可以认为每个模型输出的分别是样本类别为A,B,C,D的概率值。取概率值最大的类别作为预测输出即可。
数据集的划分
实际上数据进行划分,会将数据划分为训练集,验证集和测试集。
训练集 训练集的作用就是训练模型,训练集上的数据你会使用很多次,跑很多迭代。用它来调整模型的参数。
验证集 验证集是帮助你在训练过程中评估模型的性能,它并没有被拿来训练模型。根据验证集的评估结果,你可以调整模型的超参数,比如调整学习率,或者增加特征的高次项等。 验证集的数据你使用的比训练集要少。只在模型训练到一定阶段,评估模型的性能表现。
测试集 测试集是你训练好了模型,最后只使用一次,评价模型的最终真实表现的。
欠拟合和过拟合
欠拟合:
如果模型在训练集上表现都很差,那模型就是欠拟合。
过拟合
过拟合是模型在训练数据上指标很好,但是在验证数据集上指标很差。
梯度下降算法的改进
-
批量梯度下降(Batch Gradient Descent)
利用所有训练数据求得每个参数的平均梯度,它准确的反应了模型在整个训练数据集上的改进方向。
优点:训练稳定,收敛方向准确。
缺点:不利于模型探索不同的参数空间,可能会陷入局部最小值。
-
随机梯度下降法(Stochastic Gradient Descent)
每次只从训练集里取一个样本,然后计算loss,反向传播,计算梯度,更新模型参数。
优点:计算快,而且因为单个数据随机性很强,每次都是不同的数据在更新参数,可以帮助模型训练快速逃出局部最小值。
缺点:训练波动大,不稳定。
-
小批量梯度下降(Mini-batch Gradient Descent)
每次从训练数据集里取一小部分样本,用来训练。这样一次训练叫做一个step。而通过每次取一小部分样本(叫做一个batch),把训练集所有数据都训练一遍叫做一个epoch(迭代)。