学习目标
这篇笔记解释为什么 AI 计算需要异构架构,以及 CANN 如何连接上层框架与昇腾 NPU。学完后应能说明 Host 与 Device 的分工、NPU 内部主要模块,以及 AI Core 中计算、存储和控制模块如何协同。
先修知识
- 算子、Tensor、shape 与 format
- CPU、内存和并行计算的基础概念
- 矩阵乘法的基本计算过程
问题背景:为什么需要异构计算
CPU 擅长复杂控制、分支和通用任务,但 AI 模型包含大量规则、重复的矩阵与向量计算。若所有乘加都由 CPU 逐个执行,硬件并行能力无法充分发挥。
异构计算的思路是“让不同处理器做自己擅长的工作”:
CPU:程序控制、任务调度、数据组织
NPU:矩阵、向量等密集型并行计算
以两个 16×16 矩阵相乘为例,朴素算法包含 16×16×16=4096 次标量乘加。专用 Vector 或 Cube 单元可以同时处理更多数据,显著缩短理想计算周期。实际端到端性能还会受到数据搬运、指令调度、同步和利用率影响,不能只看理论峰值。
CANN 是什么
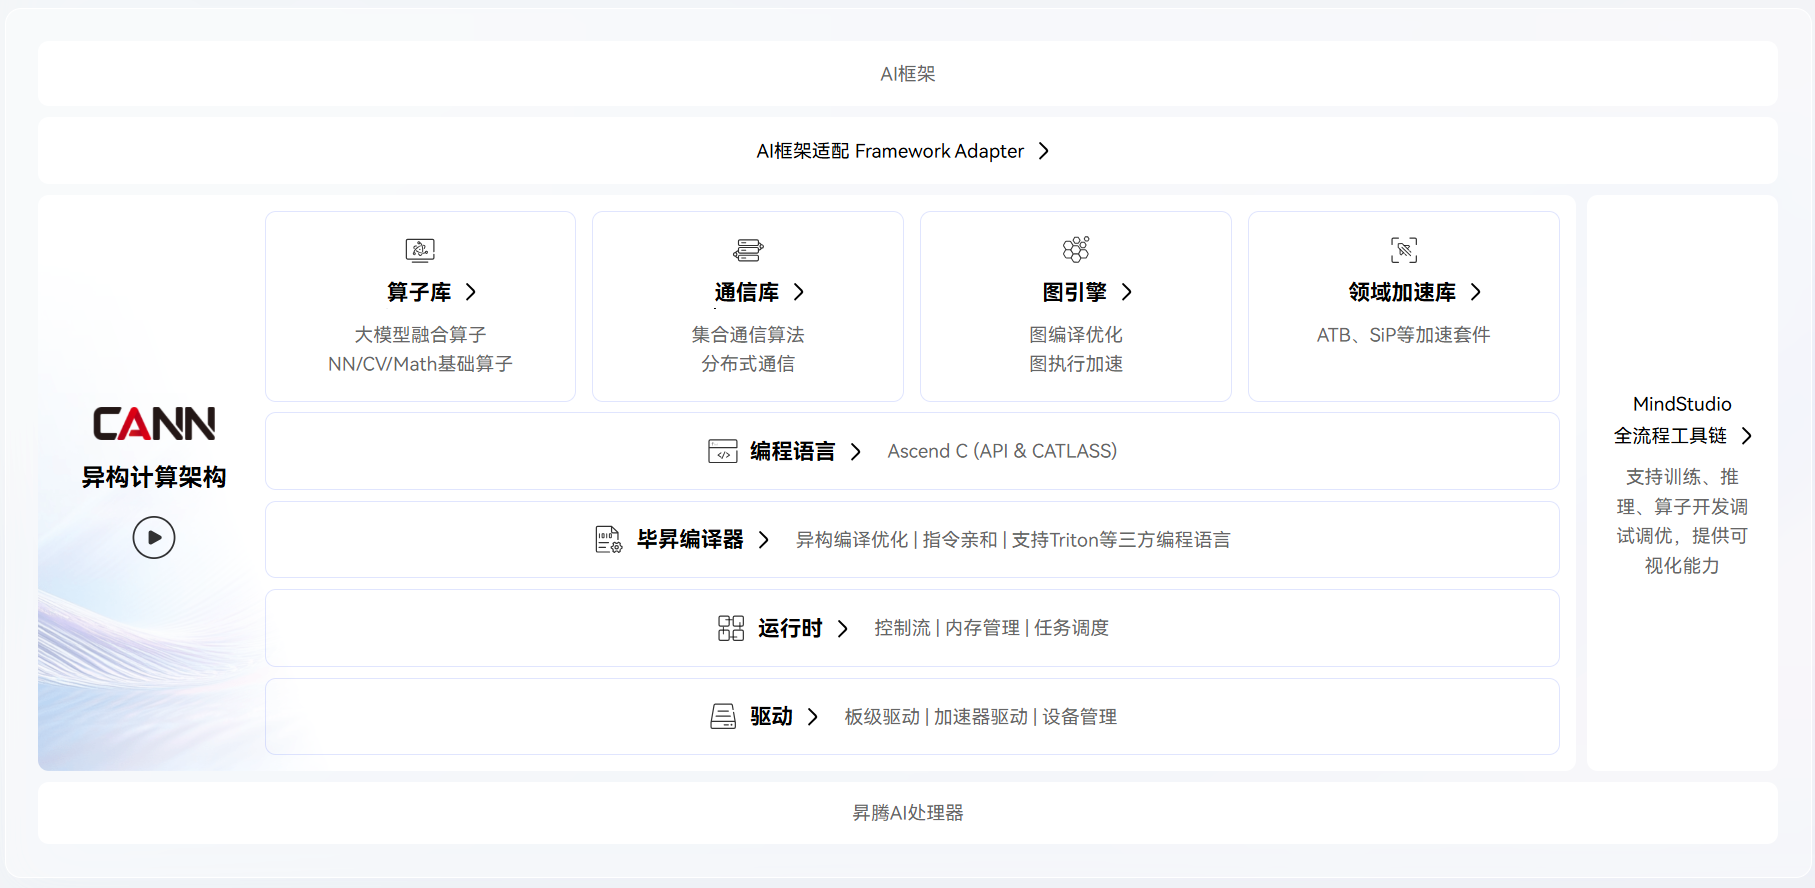
CANN(Compute Architecture for Neural Networks)是面向昇腾 AI 处理器的异构计算软件栈。它位于上层框架或应用与底层 NPU 硬件之间,主要承担三类职责:
- 将上层计算需求转换为 NPU 可执行的任务;
- 提供算子、通信、运行时和开发接口;
- 调度与优化硬件资源,使算力得到更有效的利用。
可以把它理解为 NPU 的“翻译官 + 调度员”,但它不只是单一编译器,而是一套分层的软件平台。
下图来自课程原 Notebook,展示了 CANN 对上连接框架与应用、对下连接昇腾硬件的分层位置。阅读时先抓住“上层表达计算、CANN 转换与调度、底层执行计算”这条主线。
Host 与 Device
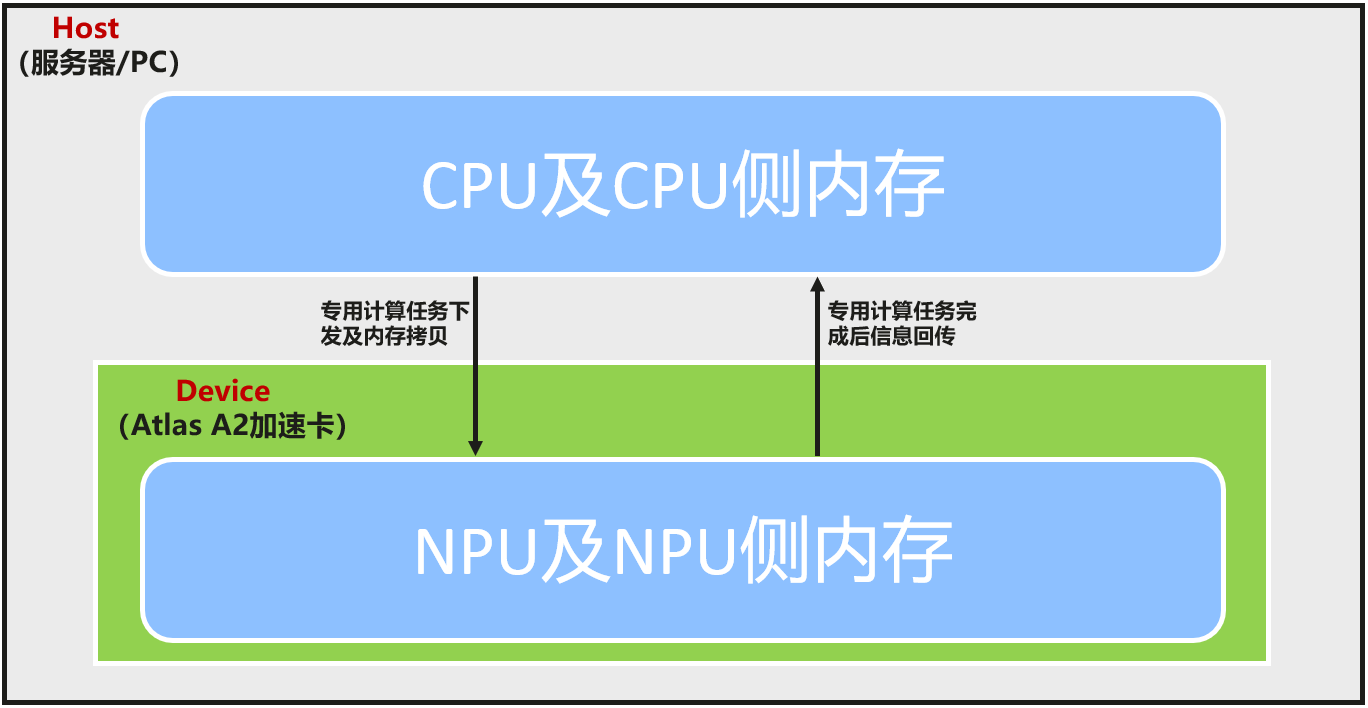
典型的异构执行过程如下:
Host 准备任务与数据
        ↓
把数据传到 Device 内存
        ↓
NPU 执行密集型计算
        ↓
把结果传回 Host
        ↓
Host 汇总结果并继续业务逻辑| 侧 | 典型硬件 | 主要职责 |
|---|---|---|
| Host | 服务器 CPU 与主机内存 | 发起任务、逻辑判断、数据传输调度、结果汇总 |
| Device | 昇腾 NPU 与设备内存 | 承接矩阵、向量等密集型并行计算 |
优化程序时不仅要关注 NPU 上的计算速度,也要关注 Host 与 Device 之间的数据传输成本。
下图展示了典型服务器中 Host 与昇腾 Device 的物理关系,以及任务和数据在两侧之间的流动。
NPU 内部主要模块
AI Core
AI Core 是昇腾 NPU 的核心计算单元,大部分适合并行加速的算子在这里执行。
AI CPU
AI CPU 补充处理不适合 AI Core 的任务,例如轻量逻辑、并行度较低或硬件专用单元不易覆盖的辅助算子。
控制与调度模块
控制 CPU 和任务调度器负责协调 NPU 内部模块、分配任务并维护执行时序。
设备内存与专用预处理模块
设备内存保存输入、中间结果和输出。数字视觉预处理模块可承担图像编解码、格式转换等任务,减少通用计算单元的负担。
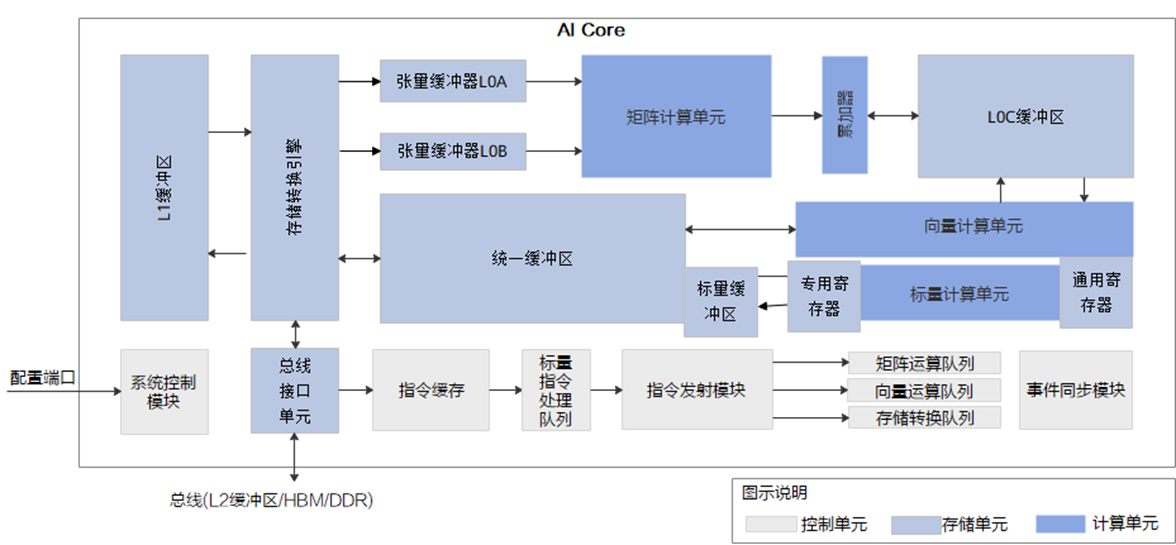
AI Core 的计算单元
| 单元 | 擅长的工作 | 典型任务 |
|---|---|---|
| Cube Unit | 矩阵乘加 | 卷积、矩阵乘 |
| Vector Unit | 向量运算 | 激活、归一化、逐元素计算 |
| Scalar Unit | 标量计算与控制 | 循环、分支、地址计算、参数配置 |
以课程中的硬件示例为准,Cube 单元可在一个时钟周期内并行执行大规模矩阵乘加;Vector 单元可以并行处理一组 FP16、FP32 或整数数据;Scalar 单元则像 AI Core 内部的“小型控制 CPU”。具体能力会随芯片代际和型号变化。
AI Core 的存储系统
计算单元速度很快,但如果数据供应不及时,计算单元仍会空闲。AI Core 采用分层片上存储来提高数据复用率、降低外部访问延迟。
主要组成包括:
- 存储转换引擎:负责不同缓冲区之间的数据读写,以及 Padding、Transpose、Img2Col 等转换;
- L1、L0A、L0B、L0C、统一缓冲区等片上缓冲:保存高频输入和中间结果;
- 寄存器:为 Scalar 单元保存数据、指令和控制参数。
性能优化的一个核心思想是:让数据尽可能在更靠近计算单元的位置被复用,减少慢速层级之间的重复搬运。
AI Core 的控制系统
不同硬件流水线可以并行工作,但任务之间常有数据依赖。控制系统负责预取、解码、分发、执行和同步指令:
指令预取
  ↓
标量指令处理与地址计算
  ↓
按类型分发到 Cube / Vector / 存储转换队列
  ↓
各队列并行执行
  ↓
事件同步模块处理跨队列依赖
例如,向量加法依赖矩阵乘结果时,必须保证矩阵乘先完成。事件同步机制用于表达并满足这种先后关系。
下图是课程给出的 AI Core 总体架构。可以把它按“计算、存储、控制”三部分阅读:先找到 Cube、Vector 和 Scalar,再观察各级缓冲区与指令队列如何把它们连接起来。
完整计算流程
一次典型算子执行可以概括为:
- Host 通过 CANN 接口准备并下发任务。
- 输入数据进入 Device 内存。
- 控制单元把不同类型指令分发到对应队列。
- 数据搬运与 Cube、Vector 等流水线并行工作。
- 对存在依赖的流水线进行事件同步。
- 结果写回 Device 内存,必要时再传回 Host。
环境验证
安装驱动和 CANN 后,可以先检查硬件状态:
npu-smi info正常情况下可看到 NPU 健康状态、功耗、温度、AI Core 利用率和内存占用等信息。
也可以通过 PyACL 查询芯片型号:
import acl

print(acl.get_soc_name())
命令可执行只说明基本驱动或接口可用;真正开始开发前,还要确认工具链版本、芯片型号、环境变量和运行权限相互匹配。
优势与局限
优势
- 通用 CPU 与专用 NPU 分工,适合 AI 密集型计算;
- CANN 屏蔽部分底层差异,并提供算子与运行时能力;
- 多条硬件流水线可并行,提高吞吐率。
局限与成本
- Host/Device 数据传输可能抵消小任务的加速收益;
- 并行流水线需要正确处理数据依赖和同步;
- 峰值算力不等于实际性能,数据布局、搬运和硬件利用率同样关键;
- 不同代际 NPU 的具体硬件结构和能力可能不同。
常见误区
- CANN 就是 NPU。 CANN 是软件栈,NPU 是硬件。
- 所有任务都应放到 NPU。 控制密集、规模很小或并行度低的任务未必适合。
- Host 负责主要矩阵计算。 典型分工中,Host 负责控制与调度,Device 负责密集计算。
- Cube、Vector、Scalar 只能串行执行。 不同队列可异步并行,但有依赖时必须同步。
- 理论峰值等于程序实测性能。 数据搬运、指令开销和利用率都会影响实际结果。
一句话总结
CANN 的本质是连接 AI 应用与昇腾 NPU 的异构计算软件栈,通过 Host/Device 分工和 AI Core 多流水线协同来释放专用硬件算力。
复习卡片
- 核心问题:怎样让通用控制与 AI 密集计算各用其长?
- 软件桥梁:CANN。
- 硬件分工:Host 控制调度,Device 密集计算。
- AI Core 计算单元:Cube、Vector、Scalar。
- 性能关键:计算、数据搬运与同步的协同。
- 主要风险:传输开销、流水线依赖、硬件利用率不足。
自测问题
- 为什么矩阵密集型 AI 工作负载适合异构计算?
- CANN 在上层框架和 NPU 之间承担哪些职责?
- Host 与 Device 的核心分工是什么?
- Cube、Vector、Scalar Unit 分别适合什么任务?
- 为什么理论峰值算力不能直接代表端到端性能?
参考答案
- 专用硬件能并行执行大量规则的矩阵和向量运算,CPU 则更适合控制与通用逻辑。
- 转换计算需求、提供算子与运行时接口、调度和优化 NPU 资源。
- Host 负责发起、控制、传输调度和汇总,Device 负责密集并行计算。
- Cube 做矩阵乘加,Vector 做向量与逐元素运算,Scalar 做标量计算和控制。
- 实际性能还受数据搬运、同步、指令开销和硬件利用率等因素影响。
图片来源
本文图片取自 CANN Learning Hub:CANN 架构与昇腾 NPU 原理,本地保存仅用于学习笔记。