学习目标
- 使用
msprof op采集可执行程序的上板性能; - 认识
PipeUtilization.csv等主要交付件; - 用理论耗时与实测数据共同判断计算、搬运或 Scalar 瓶颈;
- 通过单变量对照实验验证优化是否有效。
前提:先保证功能正确
Profiling 不是功能调试工具。开始采集前,测试程序至少应满足:
- 可以独立编译并稳定运行;
- 输入规模、数据类型和 Tiling 固定;
- 精度校验通过;
- 运行环境、核数和频率条件可记录、可复现。
如果输入条件不断变化,优化前后的耗时就没有可比性。
msProf 的作用
msProf 用于采集和分析昇腾 AI 处理器上的算子性能。课程通过 CANN 自带的 msopprof 能力,采集单算子 API 调用程序。
最小命令如下:
msprof op --output=Sources/04.03/prof ./Sources/04.03/build/demo注意:msProf 参数位于可执行文件之前;测试程序自己的参数应放在可执行文件之后。
常用采集参数
| 参数 | 作用 | 使用场景 |
|---|---|---|
--kernel-name | 按名称或前缀选择算子 | 程序会启动多个算子时 |
--launch-count | 设置最大采集次数 | 观察多次调用 |
--launch-skip-before-match | 跳过前若干次匹配 | 排除初始化或前几轮执行 |
--warm-up | 预热设备 | 避免低频状态影响短算子测量 |
--output | 指定输出目录 | 保留基线和优化后两组数据 |
主要性能文件看什么
| 文件 | 重点信息 |
|---|---|
OpBasicInfo.csv | 算子名称、Block Dim、整体耗时 |
PipeUtilization.csv | Vector、Scalar、MTE 等流水的耗时和占比 |
ArithmeticUtilization.csv | Cube、Vector 指令利用情况 |
Memory.csv | 各层级内存读写带宽 |
MemoryUB.csv | UB 相关读写和流水信息 |
MemoryL0.csv | L0A、L0B、L0C 带宽信息 |
L2Cache.csv | L2 Cache 命中情况 |
ResourceConflictRatio.csv | Bank Conflict 和资源冲突比例 |
visualize_data.bin | 供可视化工具使用的综合数据 |
不要一开始就把所有表格全部展开。先用整体耗时和流水占比确定方向,再进入带宽、Cache 或冲突指标。
从理论值建立性能尺度
搬运理论耗时
课程示例:搬运一个 的 float 矩阵,若峰值带宽约为 :
计算理论耗时
理论值是下界参考,不是对实测的保证。小块搬运、共享带宽、指令启动、同步、访存模式和并行度都会造成差距;峰值规格还会随芯片型号和数据类型变化。
PipeUtilization 的阅读顺序
对 Vector 算子,可以优先关注:
| 字段 | 含义 |
|---|---|
aiv_time(us) | 单个 AI Vector Core 的整体执行时间 |
aiv_total_cycles | 总周期数 |
aiv_vec_time(us) / ratio | Vector 指令耗时与占比 |
aiv_scalar_time(us) / ratio | Scalar 指令耗时与占比 |
aiv_mte2_time(us) / ratio | GM → AI Core 搬入耗时与占比 |
aiv_mte3_time(us) / ratio | AI Core → GM 搬出耗时与占比 |
aiv_icache_miss_rate | 指令 Cache 未命中率 |
aiv_mte2_active_bw(GB/s) | MTE2 活跃期间的带宽 |
aiv_mte3_active_bw(GB/s) | MTE3 活跃期间的带宽 |
课程 Add 样例的采集结果中,Scalar 占比超过 90%,因此优先检查 Kernel 侧的标量逻辑,而不是盲目改动 Vector Add。
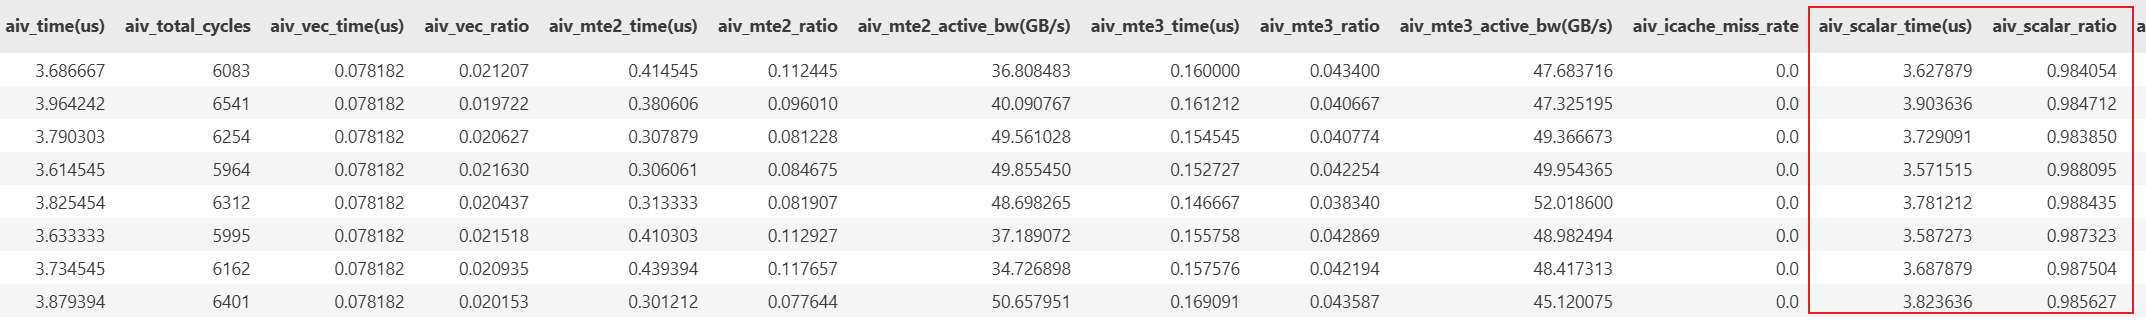
图片来源:CANN 课程
04.03_profiling_tool_usage.ipynb,展示启用打印时的性能数据。
从指标回到源码
样例中的 Scalar 工作主要来自:
Init中的长度计算和 GM 地址偏移;Process的循环控制及printf;CopyIn、CopyOut的地址偏移。
优化判断不能只看“它属于 Scalar”,还要看它是否必要、能否移到 Host,以及修改成本。课程中最明显的非必要开销是调试打印,因此先通过 CMake 关闭:
target_compile_definitions(demo PRIVATE ASCENDC_DUMP=0)重新编译、重新采集后,Scalar 耗时应显著下降:
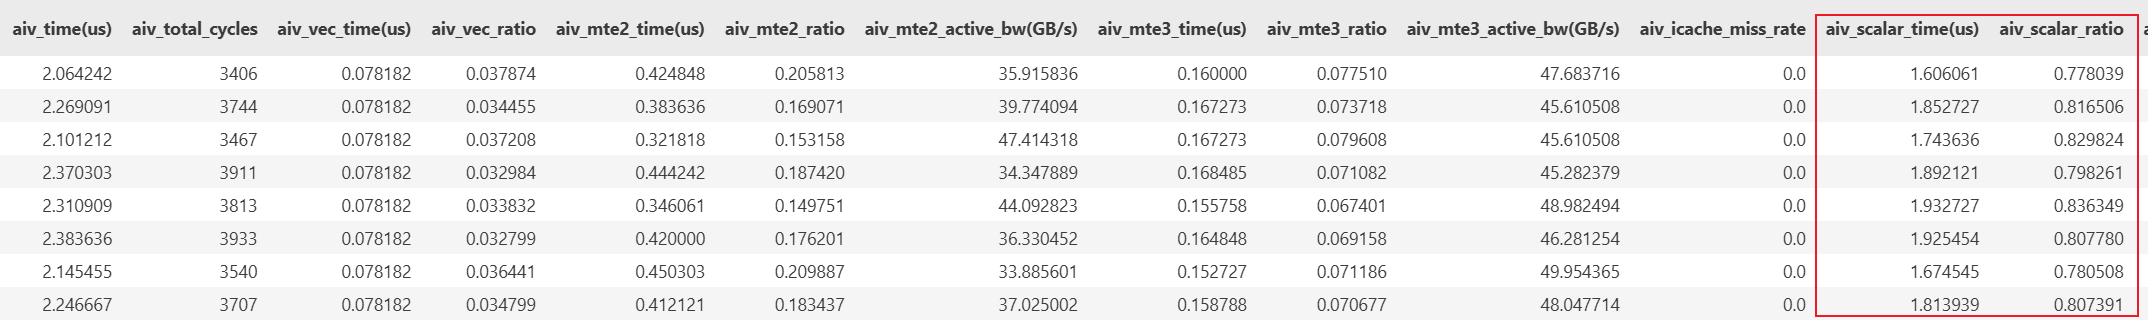
图片来源:CANN 课程
04.03_profiling_tool_usage.ipynb,展示关闭打印后的性能数据。
这一步体现了性能优化最重要的原则:每次只改变一个主要变量,然后用同样的输入重新测量。
标准调优闭环
- 建立可复现的正确性基线;
- 预热并采集基线性能;
- 找出最长流水或理论差距最大的环节;
- 提出能够被数据证伪的假设;
- 只实施一项主要修改;
- 在相同条件下重新采集;
- 同时检查精度、整体耗时和各核波动;
- 保留结果,继续下一轮。
常见误区
- 占比最高的流水一定最差:占比还受总耗时变化影响,需同时看绝对时间。
- 所有流水时间都能直接相加:存在流水重叠时,局部时间不一定等于端到端耗时;课程样例的串行表现不能推广到所有 Kernel。
- 带宽未达到峰值就是 Bug:小数据块和不连续访问本来就难以达到峰值。
- 只测一次即可:短算子容易受预热、频率和系统抖动影响,应多次测量并看分布。
- 调试版本可直接用于性能比较:打印会污染采集结果。
一句话总结
上板调优就是用真实硬件数据把“感觉哪里慢”变成“哪条流水慢、慢多少、改完是否真的变快”。
复习卡片
| 问题 | 答案 |
|---|---|
| 上板采集的基本命令? | msprof op --output=目录 可执行文件 |
| 第一张重点查看的表? | 通常是 PipeUtilization.csv |
| MTE2 表示什么方向? | GM → AI Core |
| MTE3 表示什么方向? | AI Core → GM |
| 优化实验应遵循什么原则? | 相同条件、单变量修改、重新采集 |
自测题
- 为什么既要看
ratio,也要看time(us)? - 若 MTE2 耗时很高,下一步应关注哪些指标或代码?
- 为什么短算子可能需要
--warm-up? - 关闭打印后 Scalar 占比下降,是否足以证明端到端性能一定提升?
参考答案
- 占比受总量影响,绝对时间才能说明该流水实际消耗了多少时间。
- 查看活跃带宽、搬运块大小、连续性、重复搬运,以及
CopyIn的地址和 Tile 设计。 - 避免设备尚未提频导致采样偏慢,使不同轮次更可比。
- 还需要比较整体执行时间,并确认输入、核数、频率和精度一致。
内容与图片来源
- 课程仓库:CANN LearningHub
- 参考 Notebook:
04.03_profiling_tool_usage.ipynb - 示例源码:课程内的
src/04.03/add_custom.asc