学习目标
这篇笔记为后续 Matmul 高阶 API 和 CV 融合算子打基础。学完后应能检查矩阵 shape,解释 ND 与 NZ/ZZ/ZN 分形格式的区别,并能说明矩阵乘在 Cube 上的存储数据流和两级 Tiling。
矩阵乘的输入输出
- :
[M, K]; - :
[K, N]; - :
[M, N]; - :通常为
[N],广播到结果的每一行。
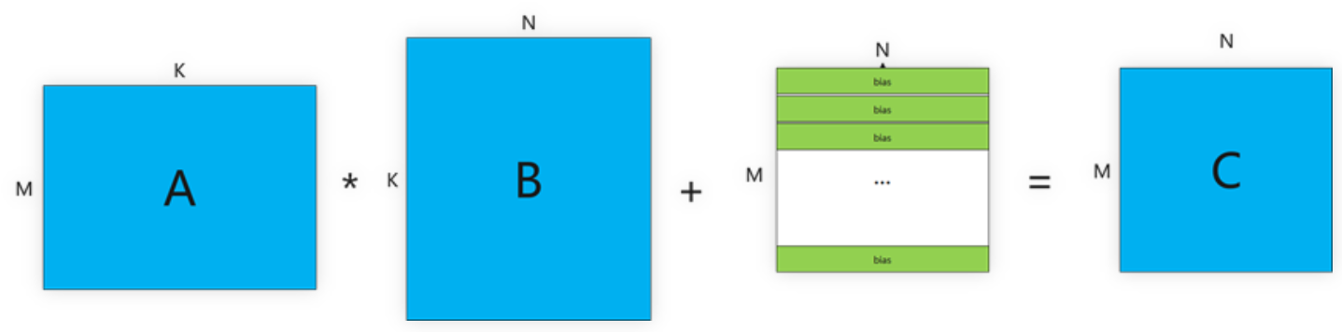
单个输出元素:
检查 shape 时,最重要的是 A 的第二维必须与 B 的第一维一致。
为什么需要分形格式
CPU 常见的 ND 行优先布局便于按行遍历,但 Cube 单元按矩阵小块并行计算。以 half 为例,典型基础块与 16×16 规模相关。若仍按普通 ND 布局取块,硬件可能需要跨行跳跃访问,影响带宽利用和数据复用。
分形格式会对矩阵进行:
Pad 对齐 → Reshape 分块 → Transpose 重排使一次 Cube 计算需要的数据在内存中更接近、对齐且适合块读取。
FRACTAL_NZ
NZ 常用于结果或某些矩阵输入。外层分形按列优先形成“N”形,分形内部按行优先形成“Z”形。
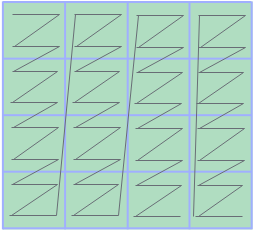
二维矩阵的概念转换:
(M, N)
  → Pad 到 (M1×M0, N1×N0)
  → Reshape 为 (M1, M0, N1, N0)
  → Transpose 为 (N1, M1, M0, N0)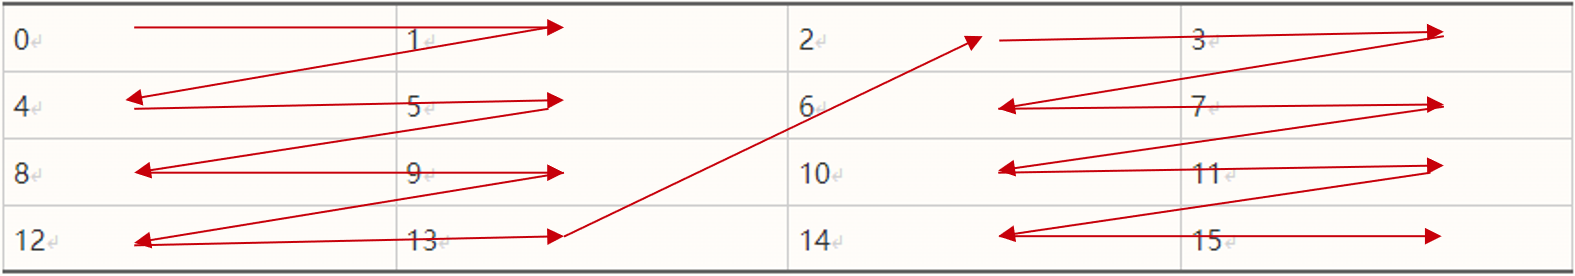
FRACTAL_ZZ 与 FRACTAL_ZN
| 格式 | 典型矩阵 | 外层分形顺序 | 分形内部顺序 |
|---|---|---|---|
| ZZ | 左矩阵 A | 行优先 Z | 行优先 Z |
| ZN | 右矩阵 B | 行优先 Z | 列优先 N |
| NZ | 结果 C | 列优先 N | 行优先 Z |
使用底层 Mmad 类接口时,A 在 L0A、B 在 L0B、C 在 L0C 往往需要匹配特定分形格式。使用 Matmul 高阶 API 时,部分搬运、切分和格式转换会被封装,但模板类型、Host Tiling 与真实输入格式仍必须一致。
分形尺寸与 dtype 位宽有关。例如 K 方向常以 32B / sizeof(dtype) 计算,因此不能把 half 的块参数机械用于 float 或 int8。
矩阵乘的数据流
重要逻辑位置:
| 位置 | 作用 |
|---|---|
| A1 / B1 | 较大的输入缓存,可类比更上层缓存 |
| A2 / B2 | 送入 Cube 的小矩阵块,对应更靠近计算单元的缓存 |
| C1 / C2 | Bias 等相关缓存位置 |
| CO1 | 小块矩阵乘结果 |
| CO2 | 汇聚后的结果 |
| VECIN / VECOUT | 与 Vector 流水线交换数据 |
典型数据路径:
A:GM → A1 → A2
B:GM → B1 → B2
计算:A2 × B2 → CO1
汇聚:CO1 → CO2
输出:CO2 → GM 或 VECIN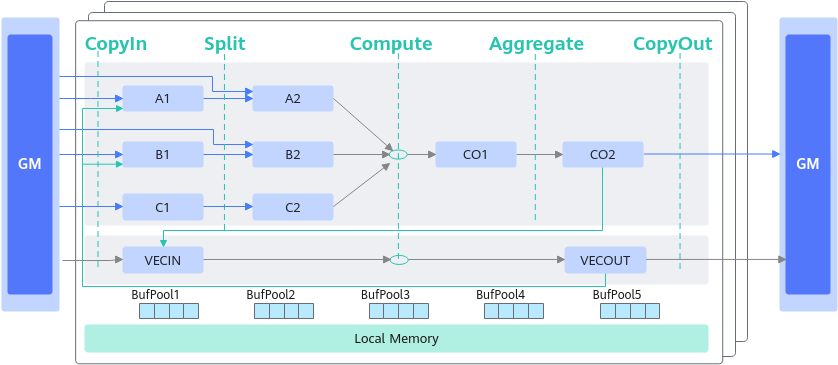
数据量较小时可能直接从 GM 搬到 A2/B2;大多数情况下先利用 A1/B1 缓存有助于隐藏搬运并提高复用。
Matmul 高阶 API 的简化视角
底层矩阵范式包含 CopyIn、Split、Compute、Aggregate、CopyOut。Matmul 高阶 API 把它简化为:
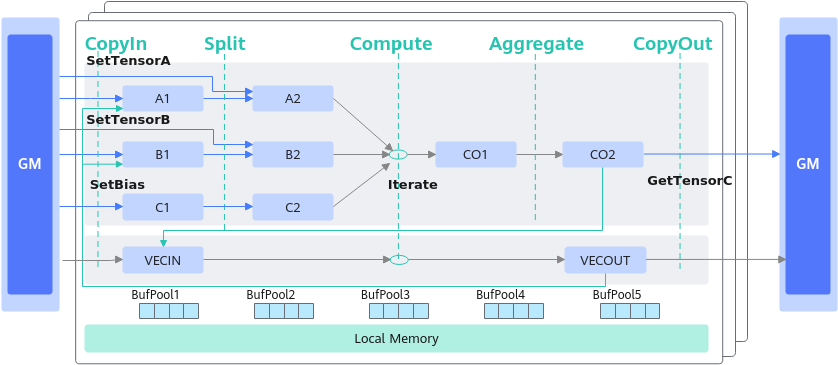
SetTensorA / SetTensorB / SetBias
                ↓
          Iterate / IterateAll
                ↓
             GetTensorC
                ↓
EndIterate:逐次计算baseM×baseN结果分片,通常在循环中配合GetTensorC;IterateAll:一次完成本核负责的singleCoreM×singleCoreN范围;End:结束本次 Matmul 并释放相关资源。
两级 Tiling
多核切分
A 沿 M 轴切分,B 沿 N 轴切分,每个核负责一个输出子矩阵:
A 子块:[singleCoreM, K]
B 子块:[K, singleCoreN]
C 子块:[singleCoreM, singleCoreN]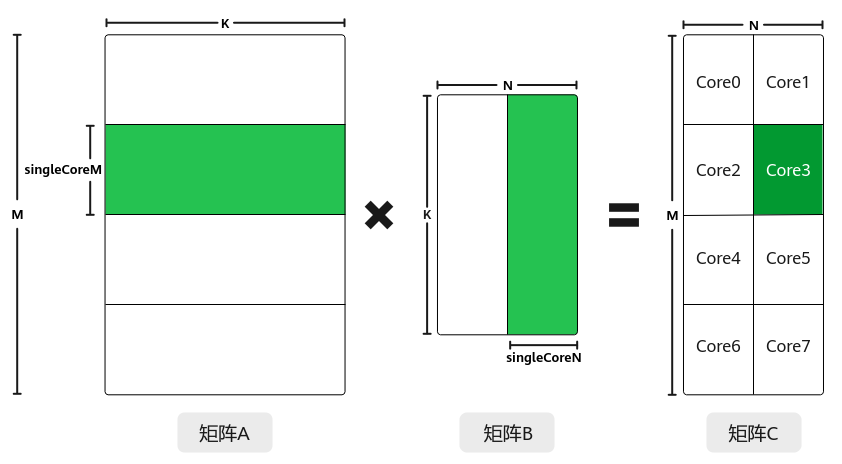
若 M 方向有 mBlocks 块、N 方向有 nBlocks 块,通常需要 mBlocks×nBlocks 个逻辑任务。K 很大时还可能沿 K 轴分段累加。
核内切分
单核负责的矩阵仍可能装不进 Local Memory,需要进一步切成 baseM×baseK 与 baseK×baseN:
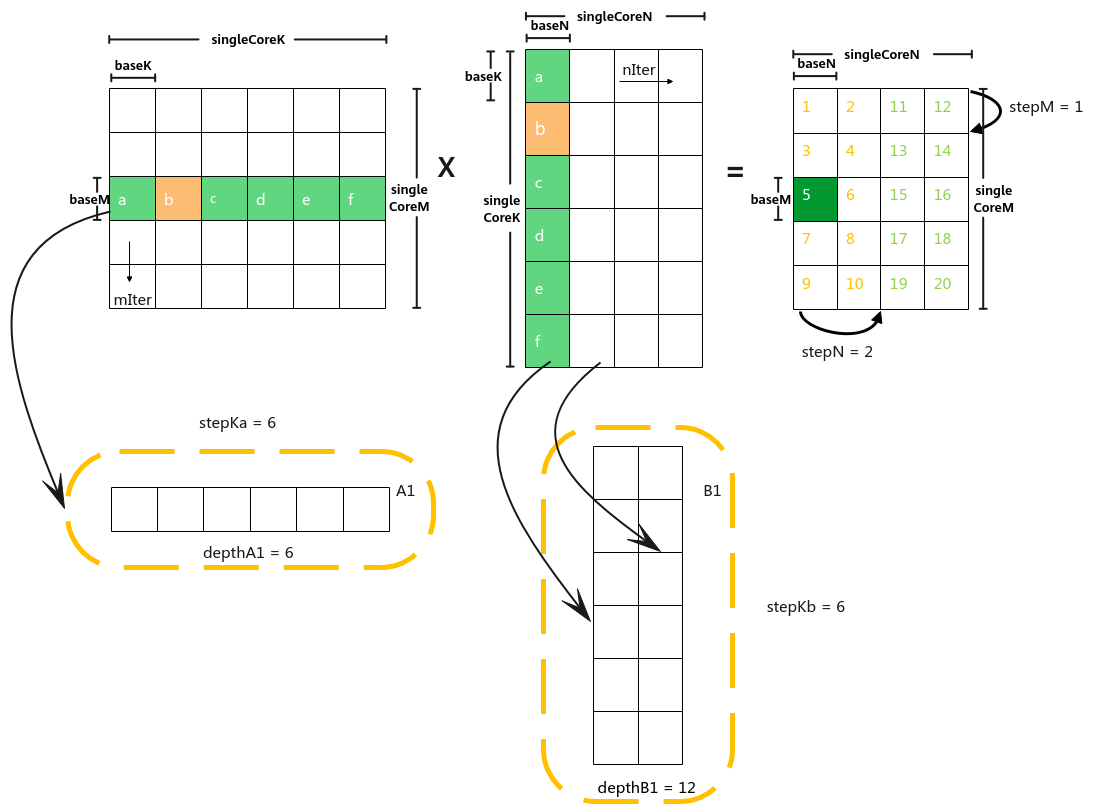
C_tile[baseM, baseN]
  += A_tile[baseM, baseK]
   × B_tile[baseK, baseN]
K 方向的多个分片会累加到同一个 C Tile。
关键 Tiling 参数
singleCoreM/N/K:单核负责范围;baseM/N/K:一次基本 Cube 计算的数据块;iterateOrder:结果 Tile 先沿 M 还是 N 方向遍历;depthA1/depthB1:A1/B1 能缓存多少份基本块;stepM/stepN/stepKa/stepKb:A1/B1 中不同方向的缓存步长。
这些参数共同影响复用、搬运量、并行度与片上存储占用,不能只追求某个 Tile 越大越好。
常见误区
- 矩阵元素数量对上就能相乘。 必须满足 A 的 K 与 B 的 K 一致。
- NZ 只是换一个 shape 名称。 它包含 Pad、分块和物理顺序重排。
- 所有 dtype 的分形尺寸相同。 K0 等参数与元素位宽有关。
- 多核只切 A。 输出二维分块通常同时涉及 A 的 M 轴与 B 的 N 轴。
- Matmul 高阶 API 让 Tiling 不再重要。 高阶 API 封装执行细节,但性能和正确性仍依赖 Tiling。
一句话总结
Ascend C 矩阵乘通过分形格式适配 Cube 块计算,并用“多核输出分区 + 核内 base Tile”两级 Tiling 组织数据复用和并行计算。
复习卡片
- Shape:
[M,K]×[K,N]→[M,N]。 - 硬件:Cube 按矩阵块计算。
- 格式:A 常见 ZZ、B 常见 ZN、C 常见 NZ。
- 数据流:GM → A1/B1 → A2/B2 → Cube → CO1/CO2。
- 多核:切 M、N 输出区域。
- 核内:
baseM/baseN/baseK。
自测问题
- Bias 为
[N]时如何作用到[M,N]输出? - 分形格式为什么有利于 Cube 计算?
singleCoreM/N/K与baseM/N/K有什么区别?- K 方向被切成多块时,结果如何得到?
参考答案
- Bias 按列广播,加到输出的每一行。
- 它把硬件一次计算需要的小块重排为更连续、对齐、可复用的存储布局。
- 前者是单核负责的总体范围,后者是单核内部一次基本计算的 Tile。
- 多个
baseK分片的乘积累加到同一个baseM×baseN结果 Tile。
图片来源
本文图片取自 3day 课程原图及 CANN Learning Hub:矩阵乘法介绍。