学习目标
这篇笔记从固定 shape 的 Add 样例进一步走向泛化:输入长度和 dtype 改变时,Host 如何根据 32 字节对齐、可用核数和 UB 容量生成切分参数。学完后应能独立推导大核、小核、普通 Tile 与尾块的大小。
为什么需要 Tiling
AI Core 的 Local Memory 容量有限,大输入无法一次全部装入。Tiling 把完整数据拆成小块,循环执行:
搬入一块 → 计算一块 → 回写一块 → 处理下一块总体层次:
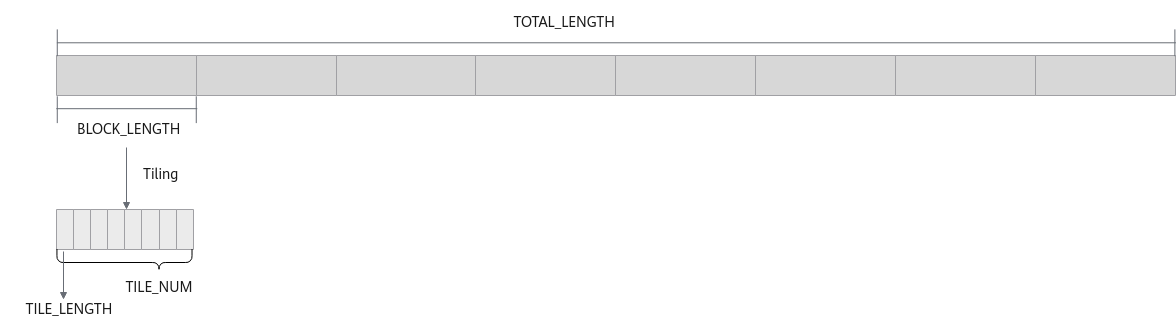
TOTAL_LENGTH:全局数据量;BLOCK_LENGTH:每个核负责的数据量;TILE_LENGTH:单核单次处理的数据量;TILE_NUM:单核循环次数。
三条设计原则
32 字节对齐
课程以 32B 为最小数据块。字节数向上对齐:
整数写法:
alignedBytes = ((inputBytes + 31) / 32) * 32;尽量提高单次搬运量
Global Memory 访问成本较高,应尽量利用 UB,使每个 Tile 足够大,减少搬运次数。但还要为所有输入、输出、临时 Tensor 和双缓冲预留空间。
多核负载尽量均衡
先按 32B 数据块均分。不能整除时,让前若干核各多处理一个块:
基础块数 = totalBlocks / coreNum
大核数量 = totalBlocks % coreNum
大核块数 = 基础块数 + 1
小核块数 = 基础块数
四种切分情况
| 核间 | 核内 | 需要处理的问题 |
|---|---|---|
| 均分 | 均分 | 最简单,无尾核、尾块 |
| 均分 | 不均分 | 尾块 |
| 不均分 | 均分 | 大核/小核或尾核 |
| 不均分 | 不均分 | 同时处理核间余数和核内尾块 |
泛化 Tiling 的目标是覆盖最后一种情况,而不是只让固定样例跑通。
示例:660 个 half 元素
条件:输入 shape=(1,660),half 每元素 2B,使用 4 个 AI Core,示例 UB 容量为 768B;Add 同时需要 x/y/z 三路空间。
第一步:向上对齐
原始字节数 = 660 × 2 = 1320B
对齐字节数 = ceil(1320 / 32) × 32 = 1344B
对齐元素数 = 1344 / 2 = 672
32B 块数  = 1344 / 32 = 42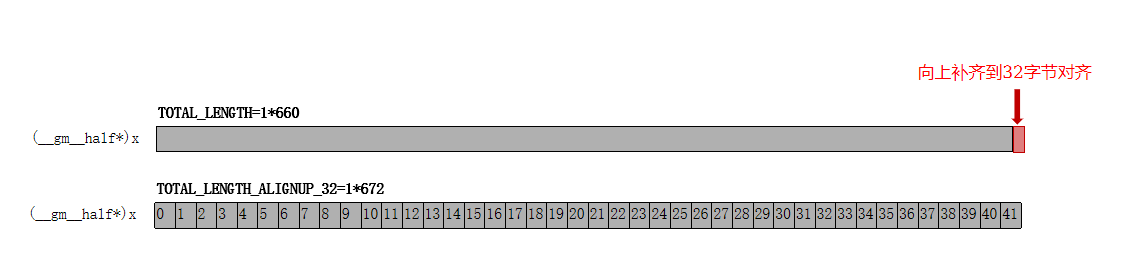
第二步:核间分配
42 / 4 = 10 余 2
前 2 核:11 个 32B 块,即 176 个 half 元素
后 2 核:10 个 32B 块,即 160 个 half 元素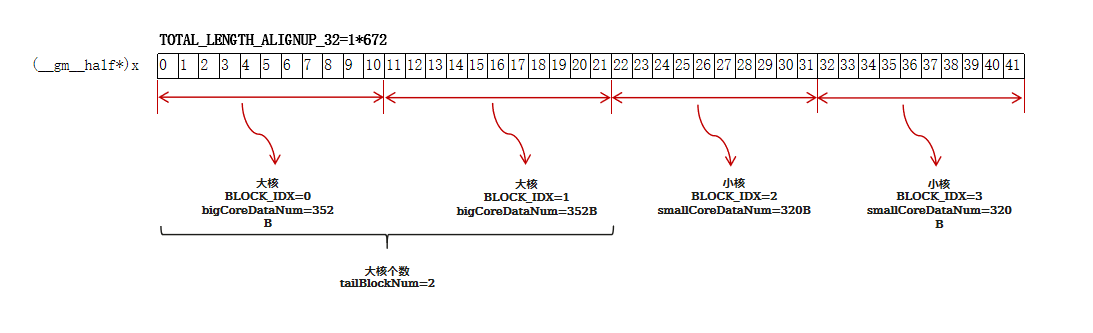
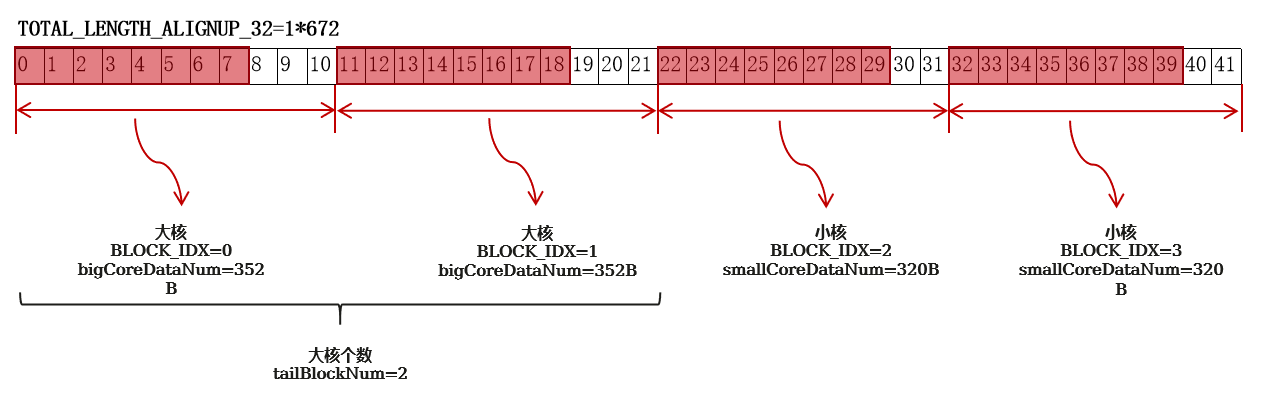
第三步:核内切块
每路最大空间 = 768B / 3 = 256B
每 Tile 元素 = 256B / 2B = 128 个 half- 大核:176 = 128 + 48;
- 小核:160 = 128 + 32。
TilingData 应保存什么
struct TilingDataTemplate {
    uint32_t smallCoreDataNum;
    uint32_t bigCoreDataNum;
    uint32_t finalBigTileNum;
    uint32_t finalSmallTileNum;
    uint32_t tileDataNum;
    uint32_t smallTailDataNum;
    uint32_t bigTailDataNum;
    uint32_t tailBlockNum;
};
这些字段共同回答:当前核属于大核还是小核、总共处理多少元素、循环多少次、最后一次处理多少元素。
Host 侧 CalcTiling
选择实际核数
coreNum = min(hardwareCoreNum, alignedBytes / 32);
coreNum = max(coreNum, 1U);
numBlocks = coreNum;
这样避免数据块少于核数时启动大量空核。
计算单 Tile 容量
Add 有两个输入和一个输出,未开启双缓冲的简化估算:
tileBlockNum = (ubSize / 32) / 3;
tileDataNum = tileBlockNum * 32 / sizeof(T);
实际工程还要扣除临时空间、系统预留和对齐损耗;启用 Double Buffer 时,缓冲份数也应进入容量预算。
计算循环与尾块
tileNum = coreBlockNum / tileBlockNum;
finalTileNum = coreBlockNum % tileBlockNum == 0
             ? tileNum
             : tileNum + 1;

tailDataNum = coreDataNum - tileDataNum * tileNum;
tailDataNum = tailDataNum == 0 ? tileDataNum : tailDataNum;
Kernel 侧如何使用
- 用
GetBlockIdx() < tailBlockNum判断大核/小核; - 计算本核 Global Memory 起始偏移;
- 选择本核的
coreDataNum/tileNum/tailDataNum; - 普通循环使用
tileDataNum,最后一次改为tailDataNum; - CopyIn、Compute、CopyOut 都使用当前
processDataNum。
大核在前、小核在后时,第 k 个核的偏移可按前面所有核实际长度累计。偏移公式必须与 Host 的分配规则严格一致。
对齐中的安全问题
“把长度向上对齐”不等于可以无条件越过原始 Tensor 边界读写。泛化实现必须明确采用哪一种策略:
- Host 为对齐后的长度真实分配并填充安全缓冲;
- 使用支持尾块/掩码的搬运和计算方式;
- 最后一块只访问原始有效元素,并正确处理对齐要求。
若只在 Tiling 中把 660 改成 672,而 Device 缓冲仍只分配 660 个元素,可能产生越界访问。
常见误区
- Tiling 只是把数据平均分。 它还要考虑对齐、UB、dtype、尾核和尾块。
- 启动全部核一定更快。 数据过小时,多核启动和同步开销可能更高。
- UB 可以全部分给输入。 输出、临时 Tensor、队列和双缓冲都要占空间。
- 向上对齐后可以直接多读几个元素。 必须保证物理缓冲和访问方式安全。
- 尾块只影响 CopyIn。 Compute 和 CopyOut 也必须使用相同的有效元素数。
一句话总结
泛化 Tiling 的本质是由 Host 根据输入和硬件约束,生成覆盖核间余数与核内尾块的安全数据分配方案。
复习卡片
- 最小粒度:课程示例为 32B。
- 核间:大核/小核处理余数。
- 核内:由 UB 容量决定 Tile。
- 尾部:大核尾块与小核尾块分别记录。
- Host:计算策略并启动正确核数。
- Kernel:按 block 索引选择参数并执行。
自测问题
- 为什么输入字节数要向 32B 对齐?
tailBlockNum表示什么?- Add 算子的 UB 容量为什么至少要在三路数据之间分配?
- 向上对齐后,怎样避免最后一块越界访问?
参考答案
- 课程硬件搬运和存储约束以 32B 为基本粒度。
- 核间均分后获得额外一个 32B 块的“大核”数量。
- 计算时需要同时容纳两个输入和一个输出。
- 分配真实填充缓冲,或使用合法的尾块/掩码访问并限制有效元素数。
图片来源
本文图片取自 CANN Learning Hub:泛化 Tiling 设计,本地保存仅用于学习笔记。