学习目标
这篇笔记解释融合算子的核心动机:减少中间结果的 Global Memory 往返与多 Kernel 调度,并让 Cube 和 Vector 流水线处理不同数据块。学完后应能判断一组算子是否适合融合,而不是把“融合”简单等同于“更快”。
什么是融合算子
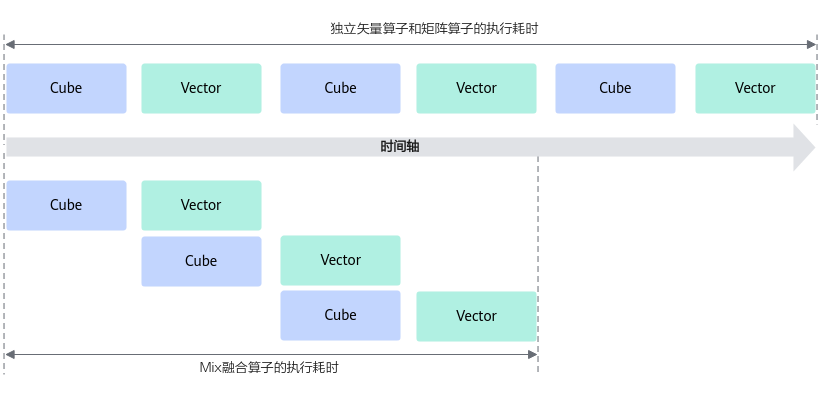
融合算子把多个有数据依赖的基础算子放进同一个 Kernel,功能上等价于原计算图的连续算子组合。
融合前:Kernel A → 写 GM → Kernel B 从 GM 读取
融合后:Kernel A 的局部结果 → Kernel B 直接消费
Cube 算子与 Vector 算子融合称为 CV 融合,也称 Mix 融合,例如:
- Matmul + Add;
- Matmul + LeakyReLU;
- Matmul + Abs;
- Matmul + Sinh。
融合前的瓶颈
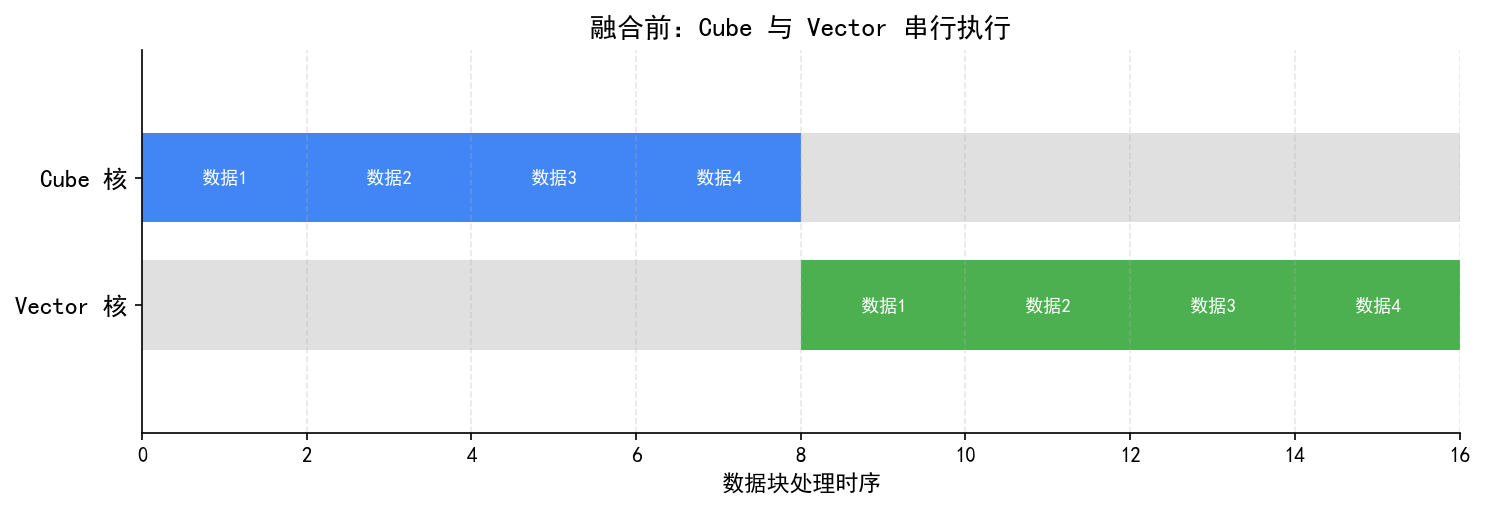
假设 Matmul 产生的完整结果由另一个 Vector 算子消费:
- Cube 输入搬入;
- Cube 计算;
- 中间结果写入 Global Memory;
- 第二个 Kernel 被调度;
- 中间结果从 GM 搬入 Vector 本地存储;
- Vector 计算并写回。
主要成本:
- 中间结果多一次 GM 写入和读取;
- 两个 Kernel 有额外调度开销;
- Cube 工作时 Vector 空闲,Vector 工作时 Cube 空闲;
- 全量生产完才能开始下游,流水线启动晚。
融合后的块级流水
把数据切成多个结果 Tile 后,可以形成生产者—消费者流水:
Cube 计算 Tile 0 → Vector 处理 Tile 0
Cube 同时计算 Tile 1
Vector 处理 Tile 1 时,Cube 计算 Tile 2
...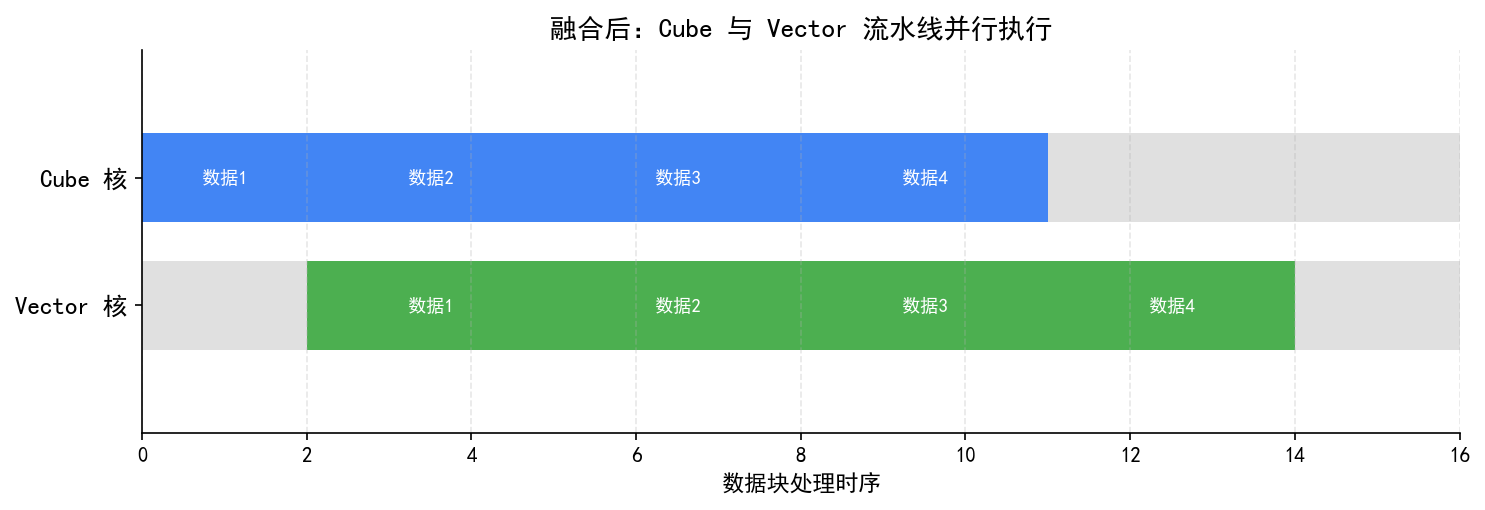
流水线总时间可近似理解为:
首块填充时间
+ (块数-1) × max(Cube阶段耗时, Vector阶段耗时)
+ 末块排空时间
而融合前更接近所有 Cube 时间与所有 Vector 时间之和。真正加速比取决于两个阶段是否均衡以及搬运是否被隐藏。
融合的主要收益
减少中间数据搬运
Matmul 结果可由 GetTensorC 直接输出到 Vector 可读的 LocalTensor/VECIN,避免完整结果先写 GM 再读回来。
减少调度次数
多个 Kernel 合并为一个 Kernel,减少 Host/运行时调度和跨 Kernel 同步。
提高硬件并行度
Cube 与 Vector 可以在不同数据块上同时工作,降低某一类计算单元的空闲时间。
利用局部性
中间 Tile 仍在片上时立即消费,通常比往返外部内存更高效。
需要澄清的两点
- 融合通常不自动减少数学运算量。 Matmul+激活的乘加和激活运算仍要执行;主要减少的是搬运、调度和等待。只有额外做代数化简或消除冗余时,算术量才可能下降。
- 融合不一定简化实现。 对用户调用接口可能更简单,但 Kernel 内部的 Tiling、偏移、同步、缓冲和精度验证通常更复杂。
什么情况下适合融合
- 算子之间是紧邻的生产者—消费者关系;
- 中间 Tensor 较大,GM 往返成本明显;
- 上下游能按兼容 Tile 粒度工作;
- Cube 与 Vector 阶段存在可重叠空间;
- 融合后的 UB/L1/L0C 资源能够容纳所需缓冲;
- shape、dtype 和 layout 组合较稳定或能设计泛化 Tiling。
什么情况下可能不值得
- 中间 Tensor 很小,调度和搬运占比低;
- 下游算子依赖完整全局结果,无法逐 Tile 消费;
- 两阶段 Tile 需求冲突,格式转换反而昂贵;
- 融合导致寄存器/片上内存压力过高;
- 一个阶段远慢于另一个阶段,流水线严重失衡;
- 维护和验证成本大于实际收益。
性能评估方法
不要只比较算子数量。至少测量:
- Kernel 总耗时;
- GM 读写量;
- Cube 与 Vector 利用率;
- 流水线空闲和同步时间;
- 不同 shape/dtype 下的收益;
- 融合前后数值误差。
常见误区
- 把两个算子写进一个文件就叫有效融合。 必须让中间数据和执行流水真正协同。
- 融合一定减少计算量。 通常减少的是搬运和调度。
- 融合一定更快。 资源压力、流水失衡和复杂同步可能抵消收益。
- 只要有 Cube 和 Vector 就能并行。 还需要块级数据依赖允许重叠。
- 功能相同就完成验证。 还要比较精度、性能、边界 shape 和资源占用。
一句话总结
CV 融合的本质是让 Cube 产生的结果 Tile 在片上直接交给 Vector,并用块级流水隐藏搬运和等待,而不是单纯减少算子名称。
复习卡片
- 主要收益:少搬运、少调度、流水并行。
- 关键数据:中间结果留在 Local Memory。
- 并行方式:Cube 处理后一块,Vector 处理前一块。
- 成立条件:Tile 兼容、资源足够、依赖允许。
- 风险:资源压力、同步复杂、收益不稳定。
自测问题
- 为什么独立 Matmul 与激活之间通常有额外 GM 往返?
- CV 融合为什么可能提高 Cube 和 Vector 利用率?
- 融合为什么通常不减少数学运算量?
- 哪些情况会让融合收益很小?
参考答案
- 独立 Kernel 通过 Global Memory 交接完整中间 Tensor。
- 两类单元可以同时处理不同结果 Tile。
- 原本的矩阵乘和激活计算仍需执行,减少的主要是数据移动与调度。
- 小中间量、不可逐块消费、流水严重失衡或资源压力过高等情况。
图片来源
本文图片取自 3day 课程原图及 CANN Learning Hub:融合算子概念介绍。