学习目标
这篇笔记记录如何使用 Matmul 高阶 API 实现可直接运行的矩阵乘算子。重点不是重写底层搬运,而是让 Host 生成正确的 TCubeTiling,并在 Cube Kernel 中正确配置 Matmul 对象。
算子规格
课程样例:
| Tensor | Shape | dtype | format |
|---|---|---|---|
| A | [1024,256] | half | ND |
| B | [256,640] | half | ND |
| Bias | [640] | float | ND |
| C | [1024,640] | float | ND |
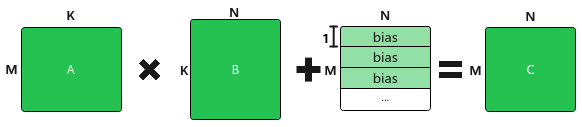
Kernel 参数除 A/B/Bias/C 外,还包括 workspace 与 TCubeTiling。
工程结构
matmul_custom_tiling.h  → Host 侧生成 TCubeTiling
matmul_custom.asc       → Kernel、Host 调用与验证
CMakeLists.txt          → 编译并链接 Tiling/Platform 库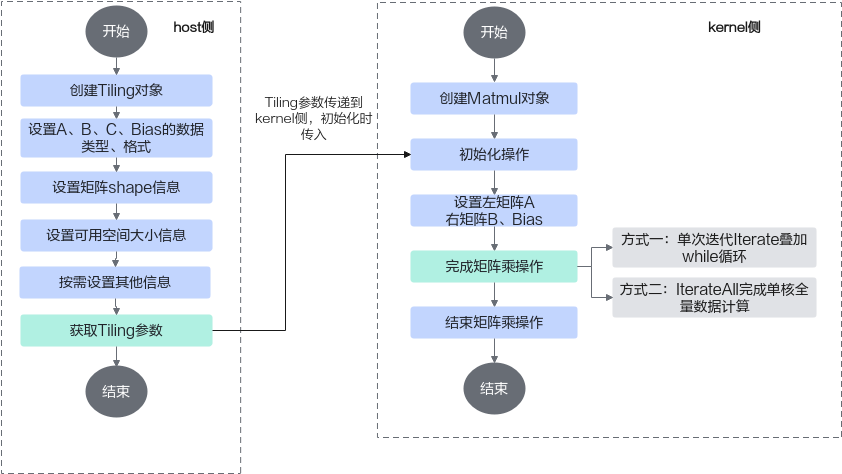
TCubeTiling 的两层信息
全局与单核范围
M/N/Ka/Kb:原始矩阵 shape;usedCoreNum:实际参与计算的核数;singleCoreM/N/K:单核负责的矩阵范围。
核内基本块与缓存策略
baseM/N/K:一次基本计算块;depthA1/depthB1:A1/B1 缓存深度;stepM/N/Ka/Kb:不同方向的缓存步长;iterateOrder:结果分片遍历顺序;isBias:是否启用 Bias。
Host 和 Kernel 必须对 M/N/K、dtype、format、是否转置、Bias 和输出位置形成一致理解。
Host 侧生成 Tiling
matmul_tiling::MultiCoreMatmulTiling cubeTiling(*platform);

cubeTiling.SetDim(numBlocks);
cubeTiling.SetAType(GM, ND, DT_FLOAT16);
cubeTiling.SetBType(GM, ND, DT_FLOAT16);
cubeTiling.SetCType(GM, ND, DT_FLOAT);
cubeTiling.SetBiasType(GM, ND, DT_FLOAT);

cubeTiling.SetShape(M, N, K);
cubeTiling.SetOrgShape(M, N, K);
cubeTiling.SetFixSplit(128, 128, -1);
cubeTiling.SetBias(true);
cubeTiling.SetBufferSpace(-1, -1, -1);

TCubeTiling tiling;
bool ok = cubeTiling.GetTiling(tiling) != -1;
baseK=-1 和 BufferSpace 的 -1 表示交给库选择。固定 baseM/baseN 便于教学,但不代表对所有 shape 和芯片最优。
Kernel 类型描述
using AType = MatmulType<TPosition::GM, CubeFormat::ND, half>;
using BType = MatmulType<TPosition::GM, CubeFormat::ND, half>;
using CType = MatmulType<TPosition::GM, CubeFormat::ND, float>;
using BiasType = MatmulType<TPosition::GM, CubeFormat::ND, float>;

Matmul<AType, BType, CType, BiasType> mm;
这些模板参数必须与 Host 的 SetAType/SetBType/SetCType/SetBiasType 一致,否则可能出现编译失败、格式解释错误或错误结果。
Cube Kernel 五步
__global__ __cube__ void matmul_custom(
    GM_ADDR a, GM_ADDR b, GM_ADDR bias, GM_ADDR c,
    GM_ADDR workspace, TCubeTiling tiling)
{
    AscendC::TPipe pipe;

    // 1. GlobalTensor 绑定 GM 地址
    // 2. 创建 Matmul 对象
    REGIST_MATMUL_OBJ(&pipe, GetSysWorkSpacePtr(), mm, &tiling);
    mm.SetOrgShape(tiling.M, tiling.N, tiling.Ka, tiling.Kb);

    mm.SetTensorA(aGlobal);
    mm.SetTensorB(bGlobal);
    mm.SetBias(biasGlobal);

    mm.IterateAll(cGlobal);
    mm.End();
}
顺序要点:先注册对象,再设置原始 shape;SetOrgShape 要在设置 A/B Tensor 前完成;计算结束必须调用 End。
Iterate 与 IterateAll
| 接口 | 行为 | 适合 |
|---|---|---|
Iterate | 一次产生一个或若干 baseM×baseN 分片 | 需要逐块后处理或融合 Vector 操作 |
IterateAll | 一次完成本核负责的 singleCoreM×singleCoreN | 纯 Matmul 直接写 GM |
独立 Matmul 样例可使用 IterateAll(cGlobal);CV 融合需要逐块拿到 LocalTensor,通常改用 Iterate + GetTensorC。
Workspace
Matmul 高阶 API 可能需要系统 workspace:
size_t workspaceSize = platform->GetLibApiWorkSpaceSize();
aclrtMalloc(&workspaceDevice, workspaceSize,
            ACL_MEM_MALLOC_HUGE_FIRST);
Host 负责按平台返回值申请并传入 Kernel。若大小为 0,应避免依赖分配零字节的未定义行为。
Host 调用流程
- 初始化 ACL、Device、Stream;
- 获取
PlatformAscendC; - 生成
TCubeTiling; - 计算 A/B/Bias/C 与 workspace 字节数;
- 分配 Device 内存并拷入输入;
- 启动
matmul_custom<<<numBlocks,...>>>; - 同步并把 C 拷回 Host;
- 进行精度验证并释放资源。
Golden 结果检查
样例 A 全为 1、B 全为 2、K=256、Bias=0.5:
C = 256 × 1 × 2 + 0.5 = 512.5练习 A 全为 -1、B 全为 2、K=512、Bias=0.5:
C = 512 × (-1) × 2 + 0.5 = -1023.5课程选择的常量恰好容易得到可精确表示的结果,但一般 Matmul 应使用 atol/rtol,不能依赖 std::equal。
CMake 关键项
find_package(ASC REQUIRED)
project(matmul_examples LANGUAGES ASC CXX)

target_link_libraries(demo PRIVATE
    tiling_api register platform m dl)

target_compile_options(demo PRIVATE
    $<$<COMPILE_LANGUAGE:ASC>:--npu-arch=${CMAKE_ASC_ARCHITECTURES}>)
tiling_api/register/platform 用于 Host Tiling 与平台信息。目标架构必须与实际 NPU 匹配。
常见误区
- Host Tiling dtype 与 Kernel 模板 dtype 不一致。 两侧配置必须完全对应。
- 忽略 workspace。 高阶 API 可能依赖系统工作区。
SetShape等于SetOrgShape。 前者描述本次/单核计算范围,后者描述原始完整矩阵。- 固定
128×128一定性能最好。 最优 Tile 与 shape、dtype、芯片和缓存有关。 - Matmul 结果总能严格相等。 累加顺序和精度会造成舍入差异。
一句话总结
Matmul 高阶 API 把底层分形搬运和 Cube 流水封装起来,但开发者仍必须保证 Host Tiling、Kernel 类型、workspace 与原始 shape 完全一致。
复习卡片
- Host:
MultiCoreMatmulTiling → TCubeTiling。 - Kernel:
Matmul<...>。 - 初始化:
REGIST_MATMUL_OBJ。 - 输入:
SetTensorA/B/Bias。 - 执行:
Iterate或IterateAll。 - 结束:
End。
自测问题
TCubeTiling在 Host 与 Kernel 之间传递什么?- 为什么 Host 的 dtype/format 配置必须与 Kernel 模板一致?
Iterate与IterateAll的主要区别是什么?- 为什么普通 Matmul 验证应使用容差?
参考答案
- 全局 shape、单核范围、基本块、缓存和遍历等矩阵切分参数。
- 两侧必须以相同方式解释地址中的数据和 Matmul 内部搬运格式。
- Iterate 逐结果 Tile 迭代,IterateAll 一次完成本核全部结果。
- half 输入、float 累加和不同累加顺序会产生正常的浮点舍入差异。
图片来源
本文图片取自 3day 课程原图及 CANN Learning Hub:基于高阶 API 的矩阵乘算子开发。