学习目标
这篇笔记回答三个问题:Ascend C 是什么、什么时候需要自定义算子,以及 Ascend C 如何抽象 AI Core。学完后应能判断是否真的需要开发自定义算子,并能描述数据从 Global Memory 搬入、计算、再搬出的完整过程。
先修知识
- 算子、Tensor 与 TensorDesc
- CANN 在 AI 软件栈中的位置
- Host、Device 与 AI Core 的基本分工
- C/C++ 变量、循环、函数、数组与指针
Ascend C 是什么
Ascend C 是 CANN 面向昇腾 NPU 算子开发提供的编程语言和 API 体系,兼容 C/C++ 的基本规范。开发者用它描述数据搬运、计算与同步,程序经过编译和运行时调度后在 NPU 上执行。
用 Ascend C 编写的自定义算子称为 Ascend C 算子。它的目标是在开发效率与硬件控制能力之间取得平衡:开发者不必直接面对全部芯片细节,但仍能控制影响性能的关键过程。
API 层级
| 层级 | 定位 | 适合场景 |
|---|---|---|
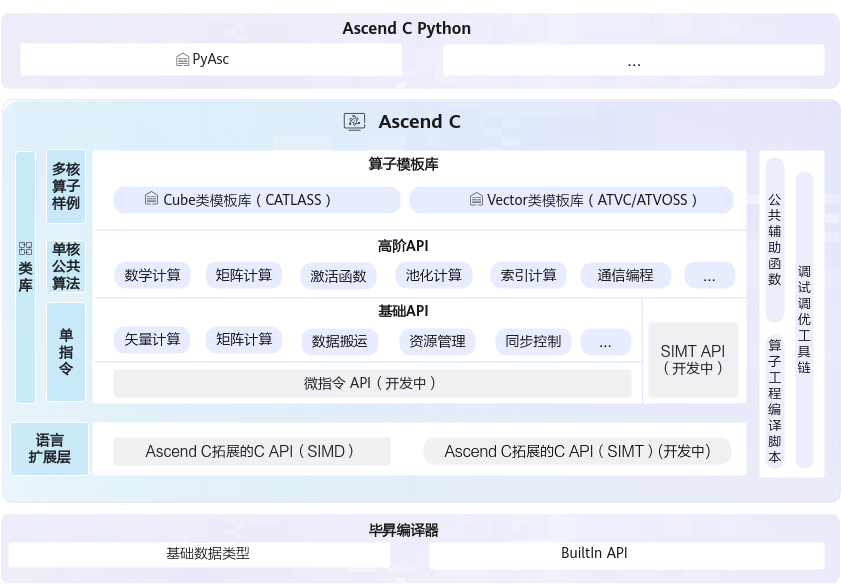
| 基础 API | 基于 Tensor 的细粒度 C++ 类库接口 | 需要灵活控制搬运、计算和同步 |
| 高阶 API | 封装常见单核算法 | 快速实现卷积、矩阵运算等常用算法 |
| 算子模板库 | 提供较完整的算子实现骨架 | 复用成熟结构并定制扩展 |
| Python 前端(PyAsc) | 使用 Python 接口表达底层计算 | 偏好 Python 开发体验的场景 |
学习路线通常先掌握基础 API 的数据流与同步逻辑,再使用高阶 API 和模板减少重复工作。
下图是课程给出的 Ascend C 总体架构。它把基础 API、高阶 API、算子模板库和 Python 前端放在同一张图中,适合用来确认不同开发入口所处的层级。
什么时候需要开发自定义算子
优先使用 CANN 已提供且性能满足要求的原生算子。只有出现明确缺口或收益时,才考虑自定义开发。
模型迁移时缺少算子
- 推理模型从 ONNX、TensorFlow 或 Caffe 转换到昇腾平台时,存在未支持算子;
- PyTorch、TensorFlow 训练脚本迁移时,框架算子在昇腾平台上不兼容。
业务计算希望由 NPU 加速
例如后处理中的 Top-K、ArgMax、数据类型转换等逻辑,如果数据已经在 Device 侧且计算规模足够大,把处理留在 NPU 上可能减少回传和 CPU 处理成本。
已有算子成为性能瓶颈
性能分析确认某个算子占用时间较高,并且现有实现无法满足业务目标时,可以针对具体 shape、dtype 或数据布局重新设计实现。
判断清单
开发前依次确认:
- 平台是否已有功能等价的原生算子?
- 能否通过算子组合或图优化满足需求?
- 性能瓶颈是否真的位于该算子,而不是数据传输或其他阶段?
- 自定义实现带来的性能收益能否覆盖开发、验证和维护成本?
Ascend C 对 AI Core 的抽象
Ascend C 将复杂硬件简化为三类关键组件:
| 组件类别 | 组件 | 作用 |
|---|---|---|
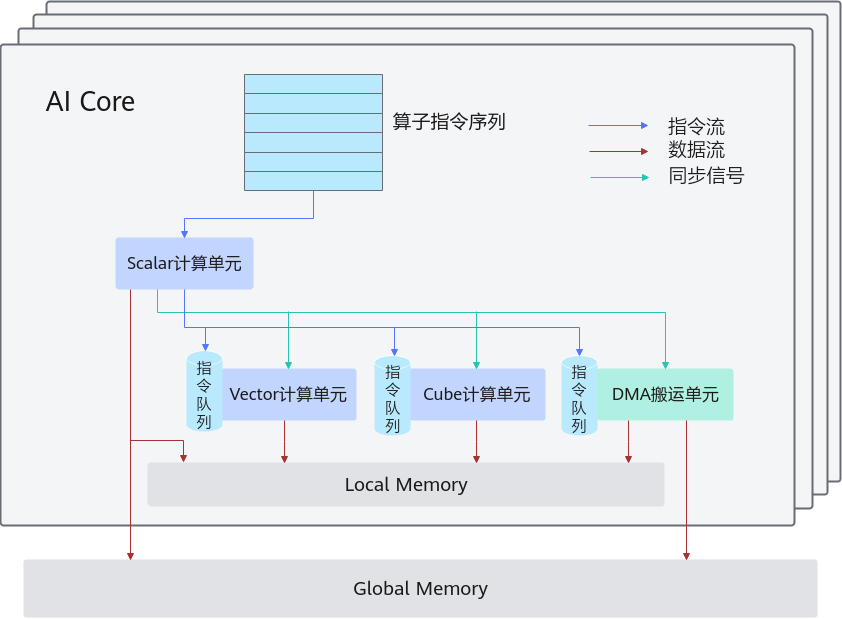
| 计算单元 | Scalar | 地址计算、循环控制、参数设置、指令发射 |
| 计算单元 | Vector | 向量与逐元素计算 |
| 计算单元 | Cube | 矩阵计算 |
| 存储单元 | Local Memory | AI Core 内部缓冲区的统称,使用 LocalTensor 表示 |
| 搬运单元 | DMA | 在 Global/Local Memory 之间及不同 Local 层级间搬运数据 |
AI Core 可访问的 Device 内存称为 Global Memory,对应 GlobalTensor。计算单元通常不能直接对 Global Memory 中的数据进行运算,数据需要先通过 DMA 搬到 Local Memory。
最小数据流
一个最基本的向量算子可以抽象为 Copy In、Compute、Copy Out 三步:
GlobalTensor(输入)
        │
        │ DMA:Copy In
        ▼
LocalTensor(片上输入)
        │
        │ Vector / Cube:Compute
        ▼
LocalTensor(片上输出)
        │
        │ DMA:Copy Out
        ▼
GlobalTensor(输出)
对应的思维框架是:
- 确定待处理数据块;
- 从 Global Memory 搬入 Local Memory;
- 在 Local Memory 上调用计算 API;
- 将结果搬回 Global Memory;
- 对下一块数据重复以上过程。
这也是后续理解 Tiling、流水线和双缓冲的基础。
下图来自课程原 Notebook,把 AI Core 抽象成计算单元、Local Memory 和 DMA。阅读时顺着红色数据流看 Copy In、Compute、Copy Out,再用绿色同步信号理解各阶段为什么不能随意乱序。
三条关键流
异步指令流
Scalar 将 DMA、Vector、Cube 等指令发射到各自队列。不同队列可以异步执行,从而让数据搬运和计算尽量重叠,提高硬件利用率。
同步信号流
异步并不等于没有顺序。如果计算依赖搬入的数据,必须等 Copy In 完成;Copy Out 也必须等待计算完成。同步信号用于表达跨队列的数据依赖,避免读到未准备好的数据或覆盖仍在使用的缓冲区。
计算数据流
计算数据流描述 Tensor 的实际移动路径:
Global Memory → Local Memory → 计算 → Local Memory → Global Memory三条流分别回答:谁执行指令、怎样保证时序、数据实际走到哪里。
直觉理解:像一间流水线厨房
- Global Memory 像仓库,容量大但离操作台较远;
- Local Memory 像操作台,容量较小但取用快;
- DMA 像搬运员,负责仓库与操作台之间的运输;
- Vector/Cube 像厨师,只处理已经放到操作台上的材料;
- Scalar 像领班,安排搬运、加工和同步顺序。
高性能算子的关键不是只让“厨师算得快”,而是让搬运、计算和等待尽量合理重叠。
实践经验
- 先保证计算正确,再逐步优化 Tiling、搬运粒度和流水线重叠。
- 明确每个 Tensor 位于 Global 还是 Local Memory,避免混淆地址空间。
- 对每个异步阶段标出生产者、消费者和同步点。
- 小算子不一定值得下沉到 NPU;启动和搬运开销可能超过计算收益。
- 性能调优必须基于分析工具和实测数据,不要仅凭算术操作数量判断瓶颈。
优势与局限
优势
- 屏蔽部分硬件型号差异,降低直接操作底层硬件的门槛;
- 可显式组织数据搬运、计算和同步,具备较强的优化空间;
- 多层 API 让开发者可以在控制能力与开发效率之间选择。
局限
- 自定义算子需要额外的正确性、精度、性能和兼容性验证;
- Local Memory 容量有限,通常必须切分数据;
- 异步队列虽然能提升并行度,也增加了依赖与同步管理难度;
- 算子维护成本会随芯片、工具链和业务 shape 的变化而上升。
常见误区
- 有需求就应该自定义算子。 原生算子或算子组合通常更省维护成本。
- AI Core 可以直接计算 Global Memory 数据。 通常要先搬入 Local Memory。
- DMA 是计算单元。 DMA 负责数据搬运,不执行向量或矩阵计算。
- 异步执行不需要同步。 只要队列间存在数据依赖,就需要正确同步。
- Scalar 只做普通加减法。 它还负责循环、地址计算、参数配置和指令发射。
一句话总结
Ascend C 算子开发的本质是把数据按块从 Global Memory 搬到 Local Memory,在 AI Core 上计算后再搬回,并通过异步队列与同步机制兼顾正确性和性能。
复习卡片
- 何时开发:算子缺失、业务逻辑需加速、现有算子确为性能瓶颈。
- 优先原则:先找原生算子和可行组合,再考虑自定义。
- 数据对象:
GlobalTensor对应外部 Device 内存,LocalTensor对应片上缓冲。 - 基本流程:Copy In → Compute → Copy Out。
- 执行角色:Scalar 调度,DMA 搬运,Vector/Cube 计算。
- 性能关键:合理切分、搬运与计算重叠、正确同步。
自测问题
- 哪三类情况通常需要开发 Ascend C 自定义算子?
- 为什么不应一遇到业务需求就直接自定义算子?
GlobalTensor与LocalTensor分别对应什么存储位置?- Copy In、Compute、Copy Out 分别由哪些硬件组件完成?
- 异步指令流为什么仍需要同步信号?
参考答案
- 平台缺少所需算子、希望把合适的业务计算放到 NPU、现有算子已被实测确认为性能瓶颈。
- 原生算子和组合方案通常开发与维护成本更低,自定义实现还要承担精度、性能和兼容性验证。
GlobalTensor对应 Device 侧 Global Memory,LocalTensor对应 AI Core 片上 Local Memory。- Copy In/Out 由 DMA 完成,Compute 主要由 Vector 或 Cube 完成,Scalar 负责控制与指令发射。
- 不同队列之间可能存在生产者—消费者依赖,同步用于保证数据就绪和正确的执行时序。
图片来源
本文图片取自 CANN Learning Hub:Ascend C 算子开发的基本概念,本地保存仅用于学习笔记。