学习目标
这篇笔记用 Add 算子贯穿一次完整的 Ascend C 直调开发。学完后应能从算子规格推导所需 API,解释多核切分和核内切块,并理解 Kernel 类与 Host 调用代码的职责边界。
本文拆解固定样例的关键代码。Kernel 类各方法与核函数入口需组合使用,前面的切分示意用于解释参数;Host 侧还需要设备初始化、内存管理、错误处理和 main。运行时应使用文末官方配套工程,并匹配 CANN 版本与目标硬件。下面的入口和构建写法对照 CANN 9.0 官方 SIMD Add 示例,不能与其他版本的核函数限定符、编译模板任意混用。
算子规格分析
逐元素 Add:
课程固定样例:两个输入 x/y,一个输出 z,shape 均为 (8, 2048),dtype 为 float,format 为 ND。
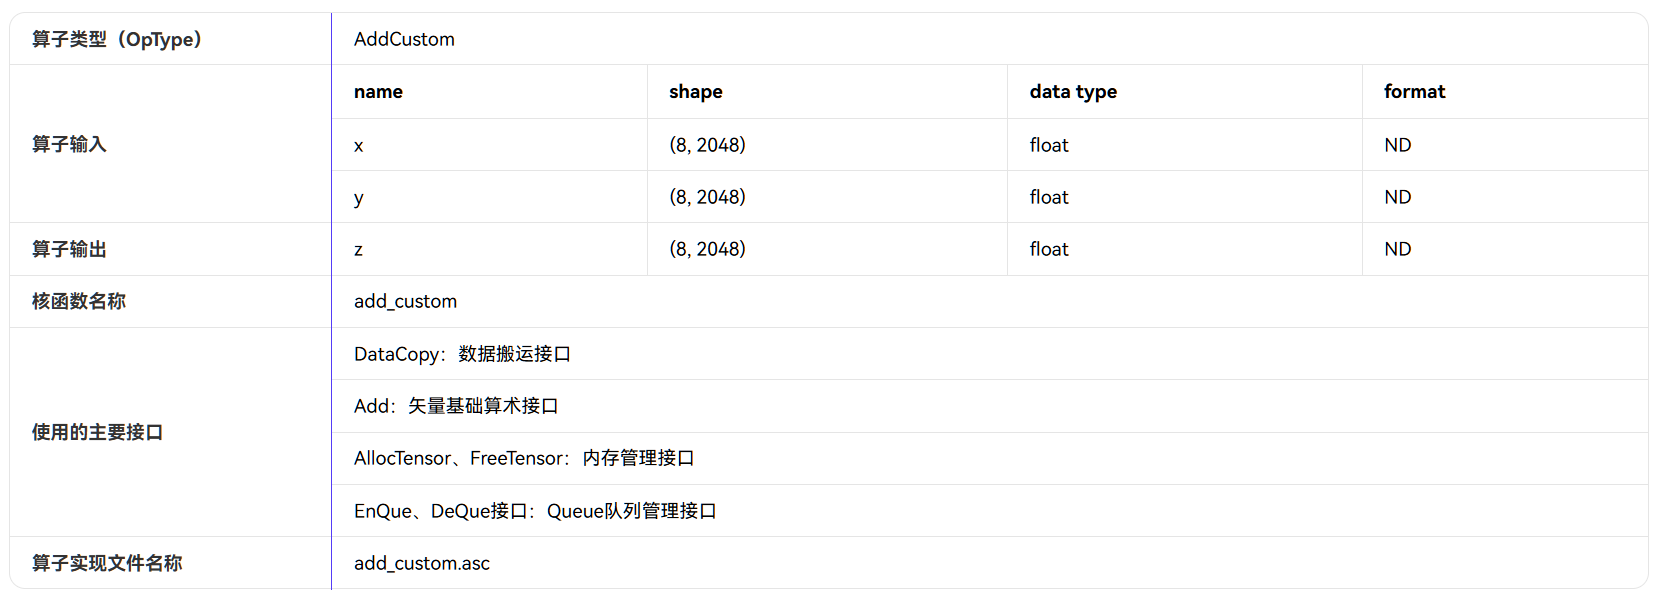
由计算过程可以直接得到 API 清单:
DataCopy:Global 与 Local Memory 之间搬运;Add:Local Memory 中的矢量加法;AllocTensor/FreeTensor:管理 LocalTensor;EnQue/DeQue:传递数据并同步流水任务。
代码组织
add_custom.asc
├─ TilingData:Host 传入切分参数
├─ KernelAdd:Device 侧算子实现类
│  ├─ Init
│  ├─ Process
│  ├─ CopyIn
│  ├─ Compute
│  └─ CopyOut
├─ add_custom:Device 侧核函数入口
├─ kernel_add:Host 侧调用封装
├─ VerifyResult:精度验证
└─ main:测试数据与程序入口
TilingData 的作用
固定样例使用:
#include <cstdint>

struct AddCustomTilingData {
    uint32_t totalLength;
    uint32_t tileNum;
};
totalLength 与启动核数决定每核数据量,tileNum 决定每个核内部的切块数。它把“如何切数据”从 Kernel 计算逻辑中抽离出来。
两级数据切分
第一级:多核切分
若总长度为 8×2048,启动 8 个核:
blockLength = totalLength / 8 = 2048
第 k 核起点 = k × blockLength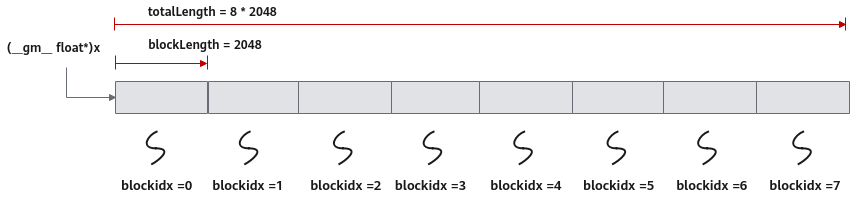
xGm.SetGlobalBuffer(
    reinterpret_cast<__gm__ float*>(x)
        + blockLength * AscendC::GetBlockIdx(),
    blockLength);
每个核必须指向不同的 Global Memory 区间,否则会重复计算或互相覆盖。
第二级:核内切块
这个样例把单核的 2048 个元素按 tileNum=8、BUFFER_NUM=2 的约定切成 16 个实际处理块,每轮处理 128 个元素:
tileLength = blockLength / tileNum / BUFFER_NUM
           = 2048 / 8 / 2
           = 128 个元素
loopCount  = tileNum × BUFFER_NUM = 16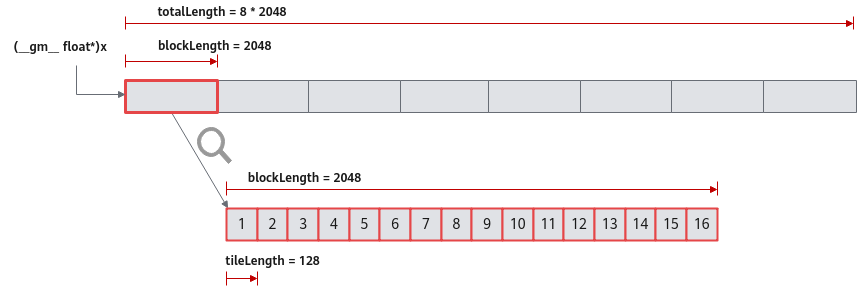
这里的 tileNum 语义容易混淆:本样例实际处理的块数是 tileNum × BUFFER_NUM。双缓冲表示每个队列有两份可交替使用的存储,并不要求所有实现都将循环次数乘 2;切块数与缓冲深度也可以分别设计。
当前代码没有尾块处理。Host 必须保证启动核数和 tileNum 为正,总长度能被核数整除,每核长度又能被 tileNum × BUFFER_NUM 整除。基础 DataCopy 的连续搬运还要求满足 32 字节对齐等接口约束:本例每块 128 × sizeof(float) = 512 字节,核间和块间偏移均满足这一条件。任意长度输入不能直接套用这里的整数除法。
Kernel 类
先定义缓冲深度和类接口。此代码块接在前面的 AddCustomTilingData 定义之后;类方法在后续代码块中依次实现。
#include "kernel_operator.h"

constexpr int32_t BUFFER_NUM = 2;

class KernelAdd {
public:
    __aicore__ inline void Init(GM_ADDR x, GM_ADDR y, GM_ADDR z,
                               uint32_t totalLength, uint32_t tileNum);
    __aicore__ inline void Process();

private:
    __aicore__ inline void CopyIn(int32_t i);
    __aicore__ inline void Compute();
    __aicore__ inline void CopyOut(int32_t i);

    AscendC::TPipe pipe;
    AscendC::TQue<AscendC::TPosition::VECIN, BUFFER_NUM> inQueueX, inQueueY;
    AscendC::TQue<AscendC::TPosition::VECOUT, BUFFER_NUM> outQueueZ;
    AscendC::GlobalTensor<float> xGm, yGm, zGm;
    uint32_t blockLength;
    uint32_t tileNum;
    uint32_t tileLength;
};
Init
Init 完成三件事:
- 计算
blockLength、tileLength和循环次数; - 根据
GetBlockIdx()设置本核的 GlobalTensor 起始地址; - 通过
pipe.InitBuffer为三个队列分配片上缓冲。
__aicore__ inline void KernelAdd::Init(
    GM_ADDR x, GM_ADDR y, GM_ADDR z,
    uint32_t totalLength, uint32_t tileNum)
{
    blockLength = totalLength / AscendC::GetBlockNum();
    this->tileNum = tileNum;
    tileLength = blockLength / tileNum / BUFFER_NUM;
    const uint32_t offset = blockLength * AscendC::GetBlockIdx();
    xGm.SetGlobalBuffer(reinterpret_cast<__gm__ float*>(x) + offset, blockLength);
    yGm.SetGlobalBuffer(reinterpret_cast<__gm__ float*>(y) + offset, blockLength);
    zGm.SetGlobalBuffer(reinterpret_cast<__gm__ float*>(z) + offset, blockLength);
    pipe.InitBuffer(inQueueX, BUFFER_NUM, tileLength * sizeof(float));
    pipe.InitBuffer(inQueueY, BUFFER_NUM, tileLength * sizeof(float));
    pipe.InitBuffer(outQueueZ, BUFFER_NUM, tileLength * sizeof(float));
}
InitBuffer 最后一个参数是单份缓冲的字节数,不是元素数。三个队列各分配两份 512 字节缓冲,数据缓冲总计 3072 字节;这不包含其他运行时资源。
Process
__aicore__ inline void KernelAdd::Process()
{
    for (int32_t i = 0; i < static_cast<int32_t>(tileNum * BUFFER_NUM); ++i) {
        CopyIn(i);
        Compute();
        CopyOut(i);
    }
}
源码按顺序调用三个阶段,底层搬运与计算流水可借助队列同步和双缓冲形成重叠。这不表示三个 C++ 函数在 CPU 意义上同时执行,也不保证双缓冲在每种切块和硬件上都能带来加速。
CopyIn
__aicore__ inline void KernelAdd::CopyIn(int32_t i)
{
    auto xLocal = inQueueX.AllocTensor<float>();
    auto yLocal = inQueueY.AllocTensor<float>();
    AscendC::DataCopy(xLocal, xGm[i * tileLength], tileLength);
    AscendC::DataCopy(yLocal, yGm[i * tileLength], tileLength);
    inQueueX.EnQue(xLocal);
    inQueueY.EnQue(yLocal);
}
Compute
__aicore__ inline void KernelAdd::Compute()
{
    auto xLocal = inQueueX.DeQue<float>();
    auto yLocal = inQueueY.DeQue<float>();
    auto zLocal = outQueueZ.AllocTensor<float>();
    AscendC::Add(zLocal, xLocal, yLocal, tileLength);
    outQueueZ.EnQue(zLocal);
    inQueueX.FreeTensor(xLocal);
    inQueueY.FreeTensor(yLocal);
}
CopyOut
__aicore__ inline void KernelAdd::CopyOut(int32_t i)
{
    auto zLocal = outQueueZ.DeQue<float>();
    AscendC::DataCopy(zGm[i * tileLength], zLocal, tileLength);
    outQueueZ.FreeTensor(zLocal);
}
核函数入口
__global__ __aicore__ void add_custom(
    GM_ADDR x, GM_ADDR y, GM_ADDR z,
    AddCustomTilingData tiling)
{
    KERNEL_TASK_TYPE_DEFAULT(KERNEL_TYPE_AIV_ONLY);
    KernelAdd op;
    op.Init(x, y, z, tiling.totalLength, tiling.tileNum);
    op.Process();
}
入口应保持轻量:创建算子对象、初始化、执行。复杂逻辑放在算子类中更容易复用和检查。
Host 侧调用
带数据的直调流程:
- 初始化 AscendCL、Device 和 Stream;
- 计算总字节数;
- 分配 Host 输出及 Device 输入输出内存;
- 把
x/y从 Host 拷到 Device; - 构造 TilingData 并启动 Kernel;
- 同步 Stream;
- 把
z拷回 Host; - 与 CPU Golden 结果比较;
- 释放所有资源。
以下启动片段位于已经完成初始化和分配的 Host 流程中;xDevice/yDevice/zDevice 是足够大的 Device 缓冲,stream 是有效的 ACL Stream:
constexpr uint32_t blockDim = 8;
AddCustomTilingData tiling{8 * 2048, 8};
add_custom<<<blockDim, nullptr, stream>>>(xDevice, yDevice, zDevice, tiling);
// 必须检查同步结果,成功后才能将输出拷回 Host 并进行校验。
const aclError syncResult = aclrtSynchronizeStream(stream);
if (syncResult != ACL_SUCCESS) {
    // 交给外层错误处理:记录错误、释放资源并终止本次验证。
    throw std::runtime_error("Add kernel synchronization failed");
}
Host 代码需包含 acl/acl.h 和 <stdexcept>。aclInit、内存分配、拷贝、同步等 ACL 调用均应检查返回值;失败路径也要清理已创建的资源。上面的异常处理片段不能替代外层资源管理。
只用常量输入容易漏掉偏移错误,应增加随下标变化的输入,逐元素构造 CPU Golden,并检查输出长度。对于有限浮点输入,可按下面的条件比较:
#include <cmath>
#include <cstddef>
#include <vector>

bool VerifyResult(const std::vector<float>& output,
                  const std::vector<float>& golden,
                  double atol = 1e-6, double rtol = 1e-6)
{
    if (!std::isfinite(atol) || !std::isfinite(rtol) || atol < 0 || rtol < 0) return false;
    if (output.empty() || output.size() != golden.size()) return false;
    for (std::size_t i = 0; i < output.size(); ++i) {
        const double actual = output[i];
        const double expected = golden[i];
        if (!std::isfinite(actual) || !std::isfinite(expected)) return false;
        if (std::abs(actual - expected) > atol + rtol * std::abs(expected)) {
            return false;
        }
    }
    return true;
}
这里的容差只是 FP32 Add 教学样例的示例值,应结合数据范围和算子精度要求选择。拒绝 NaN/Inf 是此测试的明确约定,不代表 Add 算子本身不允许这些输入。对相同有限输入执行一次同精度加法时也可以检查逐位一致,但不能据此要求所有浮点算子始终严格相等。
构建交付
包含完整 Host main、资源管理和上述 Device 实现的工程至少包含:
add_custom.asc:Host 与 Device 混合源码;CMakeLists.txt:声明 ASC/CXX 双语言项目并设置 NPU 架构。
cmake_minimum_required(VERSION 3.16)
find_package(ASC REQUIRED)
project(kernel_samples LANGUAGES ASC CXX)
set(NPU_ARCH dav-2201 CACHE STRING "Target NPU architecture")
add_executable(demo add_custom.asc)
target_compile_options(demo PRIVATE
    $<$<COMPILE_LANGUAGE:ASC>:--npu-arch=${NPU_ARCH}>)
dav-2201 是示例目标,不是自动检测结果。应按官方硬件与架构映射修改 NPU_ARCH,并加载对应 CANN 环境;不支持 ASC 语言工程的旧工具链需要使用该版本的官方构建模板。本文片段尚不足以替代完整的 add_custom.asc 和配套环境。
常见误区
- 只切核,不设置 GlobalTensor 偏移。 多核会重复处理同一段数据。
- 切块长度和循环次数不配套。 本例的块长除以了
BUFFER_NUM,因此要循环tileNum × BUFFER_NUM次才能覆盖全部数据。 - 先 Free 再 EnQue。 输出 Tensor 必须先交给下游,再在合适阶段释放。
- 固定样例等于泛化实现。 当前代码依赖整除、搬运对齐和容量约束,没有任意长度尾块处理。
- 只用常量或只看平均误差。 应检查每个输出及其有限性,并加入可以暴露核间、块间偏移错误的数据。
一句话总结
Add 样例把 Ascend C 开发归纳成“规格分析 → 两级切分 → 三级流水 → Host 调用 → 精度验证”的完整路径。
复习卡片
- 数学逻辑:逐元素
z=x+y。 - 多核:
blockLength与GetBlockIdx()。 - 核内:
tileLength与循环次数。 - 流水:CopyIn、Compute、CopyOut。
- 资源:TPipe 与三组 TQue。
- 验证:Device 输出对比 CPU Golden。
自测问题
- TilingData 为什么由 Host 构造并传给 Kernel?
blockLength × GetBlockIdx()解决什么问题?- 为什么课程样例的循环次数是 16 而不是 8?
- 固定 Add 样例距离泛化算子还缺哪些能力?
参考答案
- Host 掌握全局 shape、硬件和调度信息,可把切分策略与计算逻辑解耦。
- 它为每个核定位不同的 Global Memory 数据区间。
- 本例把
tileLength定义为2048/(8×2)=128,因此必须处理 16 块;这来自切分约定,并非双缓冲的一般定律。 - 需要处理任意 shape、dtype、核间余数、尾块和平台差异。
图片来源
本文图片取自 CANN Learning Hub:基于 Add 算子的核函数介绍,本地保存仅用于学习笔记。