学习目标
这篇笔记记录 CV 融合算子的实际代码结构。重点是让 Matmul 的 baseM×baseN 结果直接进入 Vector 计算,并正确写回全局结果矩阵。学完后应能把 LeakyReLU 替换为 Abs 或 Sinh,并识别相应的临时内存与精度需求。
算子规格
课程主例:
- A:
[M,K]half; - B:
[K,N]half; - Bias:
[N]float; - C:
[M,N]float; - 示例:
M=1024, K=256, N=640。
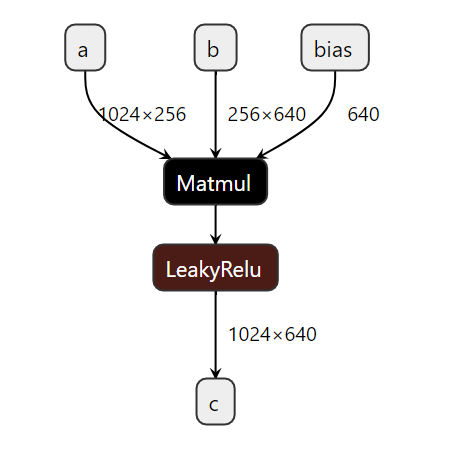
独立执行需要 Matmul 写 GM、LeakyReLU 再从 GM 读取。融合后,Matmul API 把每个结果 Tile 直接交给 Vector。
Host Tiling 的关键变化
纯 Matmul 的输出位置可设为 GM;CV 融合要让 Vector 消费 Matmul 结果,因此 C 类型配置为 VECIN:
cubeTiling.SetCType(
    matmul_tiling::TPosition::VECIN,
    matmul_tiling::CubeFormat::ND,
    matmul_tiling::DataType::DT_FLOAT);
课程示例使用:
SetFixSplit(baseM=128, baseN=128, baseK=-1);
SetTraverse(FIRSTM);
SetBias(true);
Tile 必须同时满足 L0C 的 Matmul 输出容量与 UB 中 Vector 计算、队列和临时变量的容量。
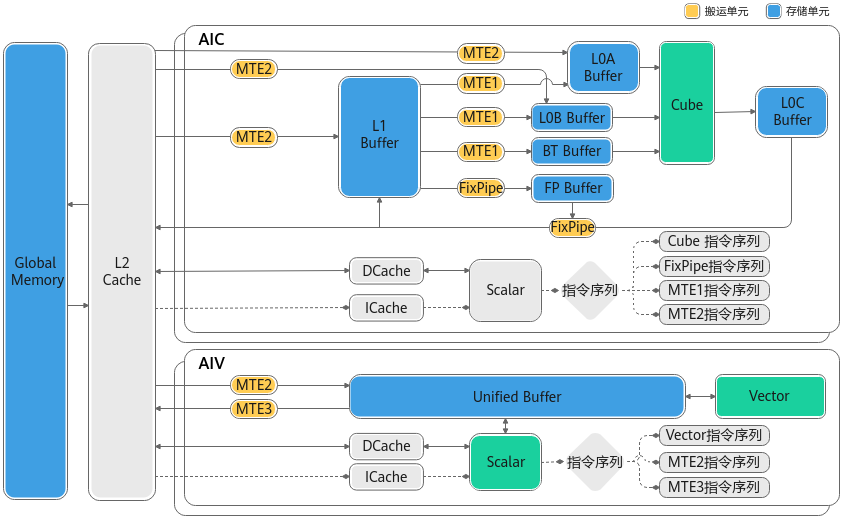
示例 Kernel 使用 __mix__(1, 2) 和特定的 SetDim(2) 配置,这是课程硬件上的演示配比,不应脱离目标产品直接照搬。
Kernel 类结构
MatmulLeakyKernel
├─ Init           设置 GlobalTensor、偏移与队列
├─ Process        逐 Matmul Tile 组织流水
├─ MatmulCompute  GetTensorC 得到 LocalTensor
├─ LeakyReluCompute
├─ CopyOut        跨行写回 GM
└─ CalcOffset     计算本逻辑任务的 A/B/C/Bias 起点
Matmul 对象的 C 类型同样使用 VECIN:
Matmul<
    MatmulType<GM, ND, AType>,
    MatmulType<GM, ND, BType>,
    MatmulType<VECIN, ND, CType>,
    MatmulType<GM, ND, BiasType>> matmulObj;
逐 Tile 处理流程
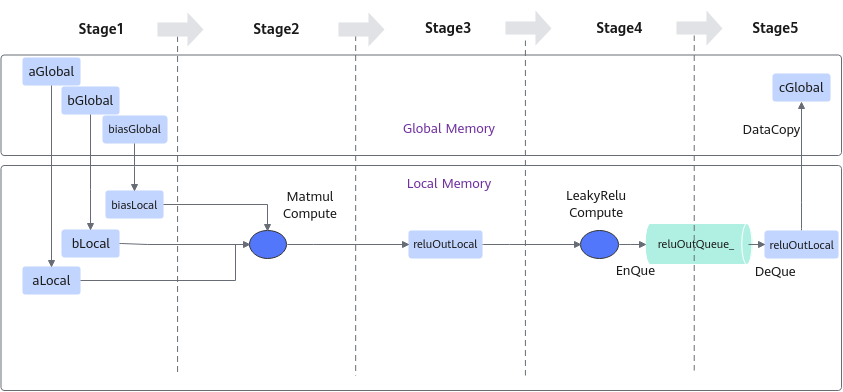
matmulObj.SetTensorA(aGlobal);
matmulObj.SetTensorB(bGlobal);
matmulObj.SetBias(biasGlobal);

uint32_t round = 0;
while (matmulObj.Iterate<true>()) {
    MatmulCompute();
    LeakyReluCompute();
    CopyOut(round++);
}
matmulObj.End();
获取 Matmul 结果
auto local = outQueue.AllocTensor<float>();
matmulObj.GetTensorC<true>(local, false, true);
原地执行 Vector 操作
AscendC::LeakyRelu(
    local, local, alpha,
    tiling.baseM * tiling.baseN);
outQueue.EnQue(local);
只有 API 明确允许输入输出别名时才能原地计算。
多核分块偏移
按 M 优先遍历时:
mBlocks  = ceil(M / singleCoreM);
mCoreIdx = blockIdx % mBlocks;
nCoreIdx = blockIdx / mBlocks;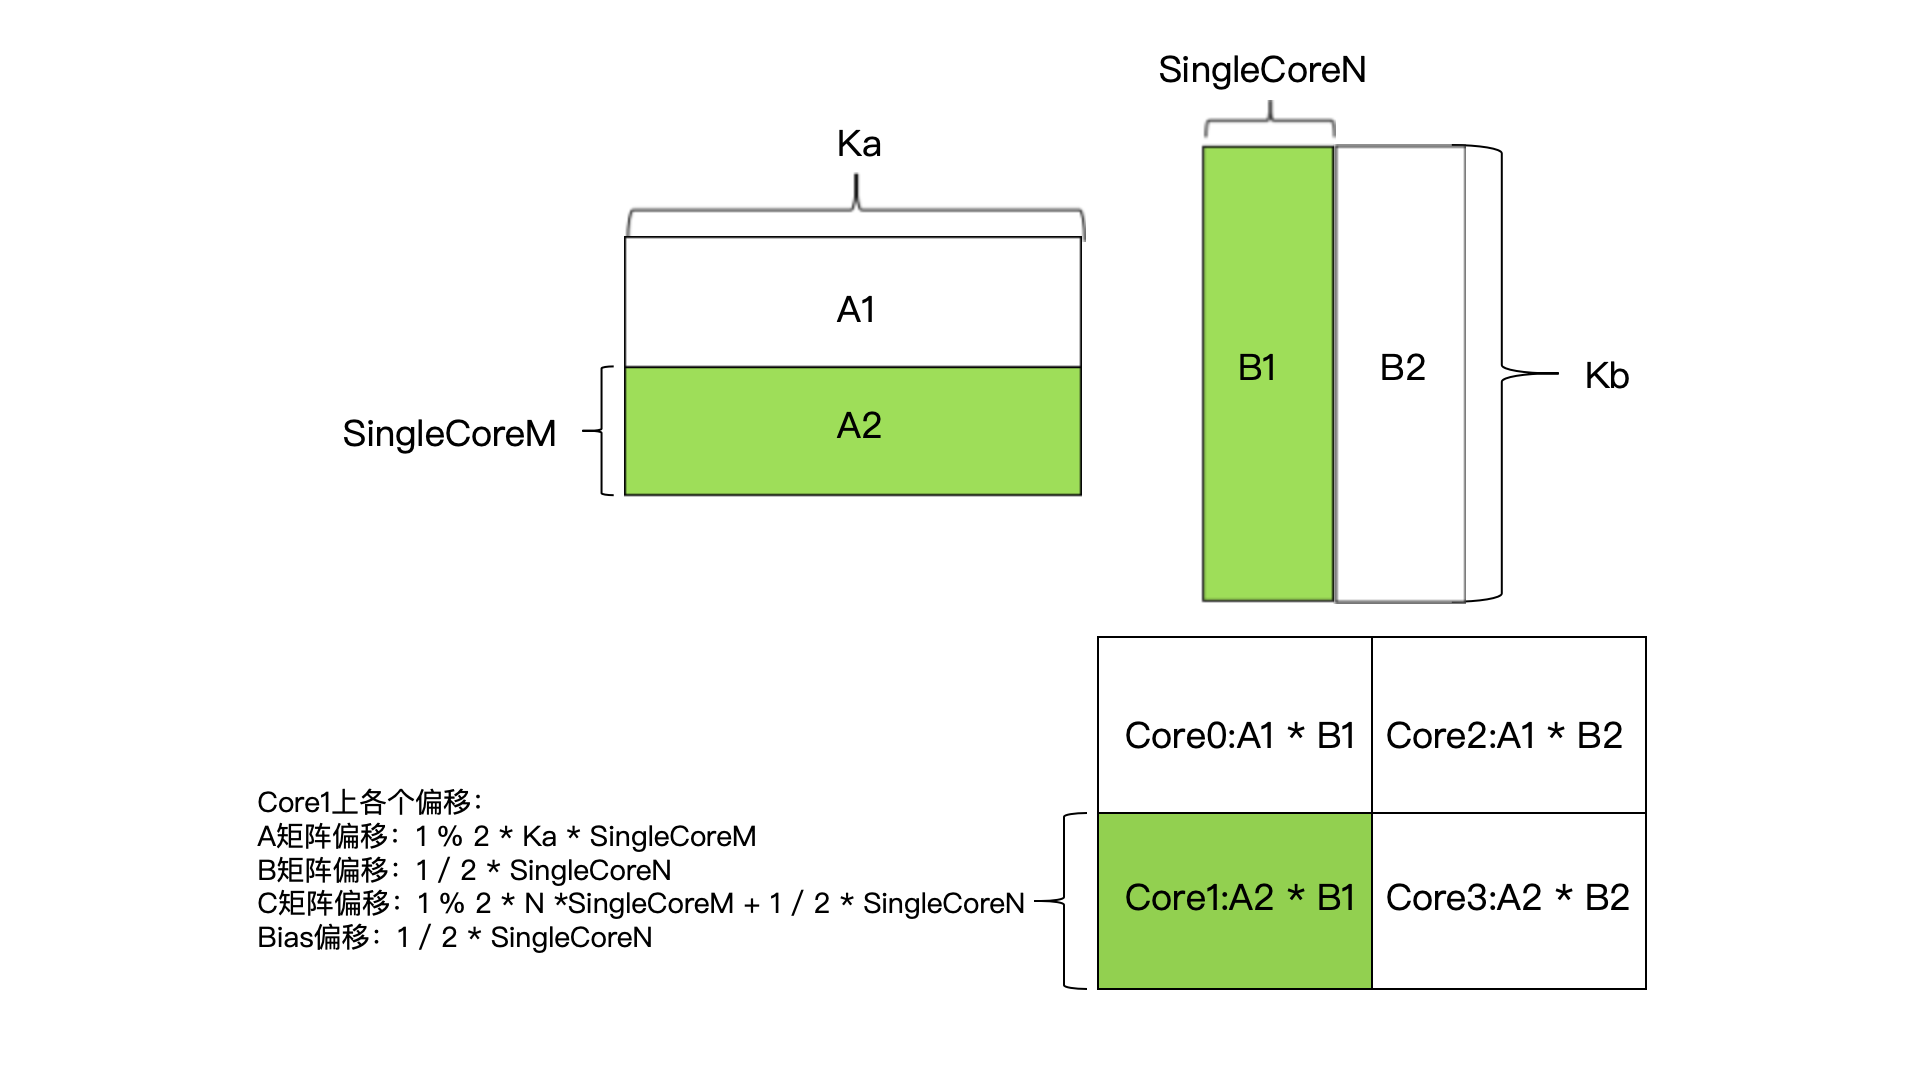
未转置 ND 矩阵的典型偏移:
offsetA    = mCoreIdx × singleCoreM × K
offsetB    = nCoreIdx × singleCoreN
offsetC    = mCoreIdx × singleCoreM × N
           + nCoreIdx × singleCoreN
offsetBias = nCoreIdx × singleCoreN
若矩阵转置、layout 改变或边界核尺寸变小,公式也必须相应调整。
为什么 CopyOut 不能连续整块写
LocalTensor 中的结果 Tile 是紧凑的 baseM×baseN;全局 C 的每行长度是 N。写完 Tile 的一行后,需要跳过 N-baseN 个元素,才能到下一行目标位置。
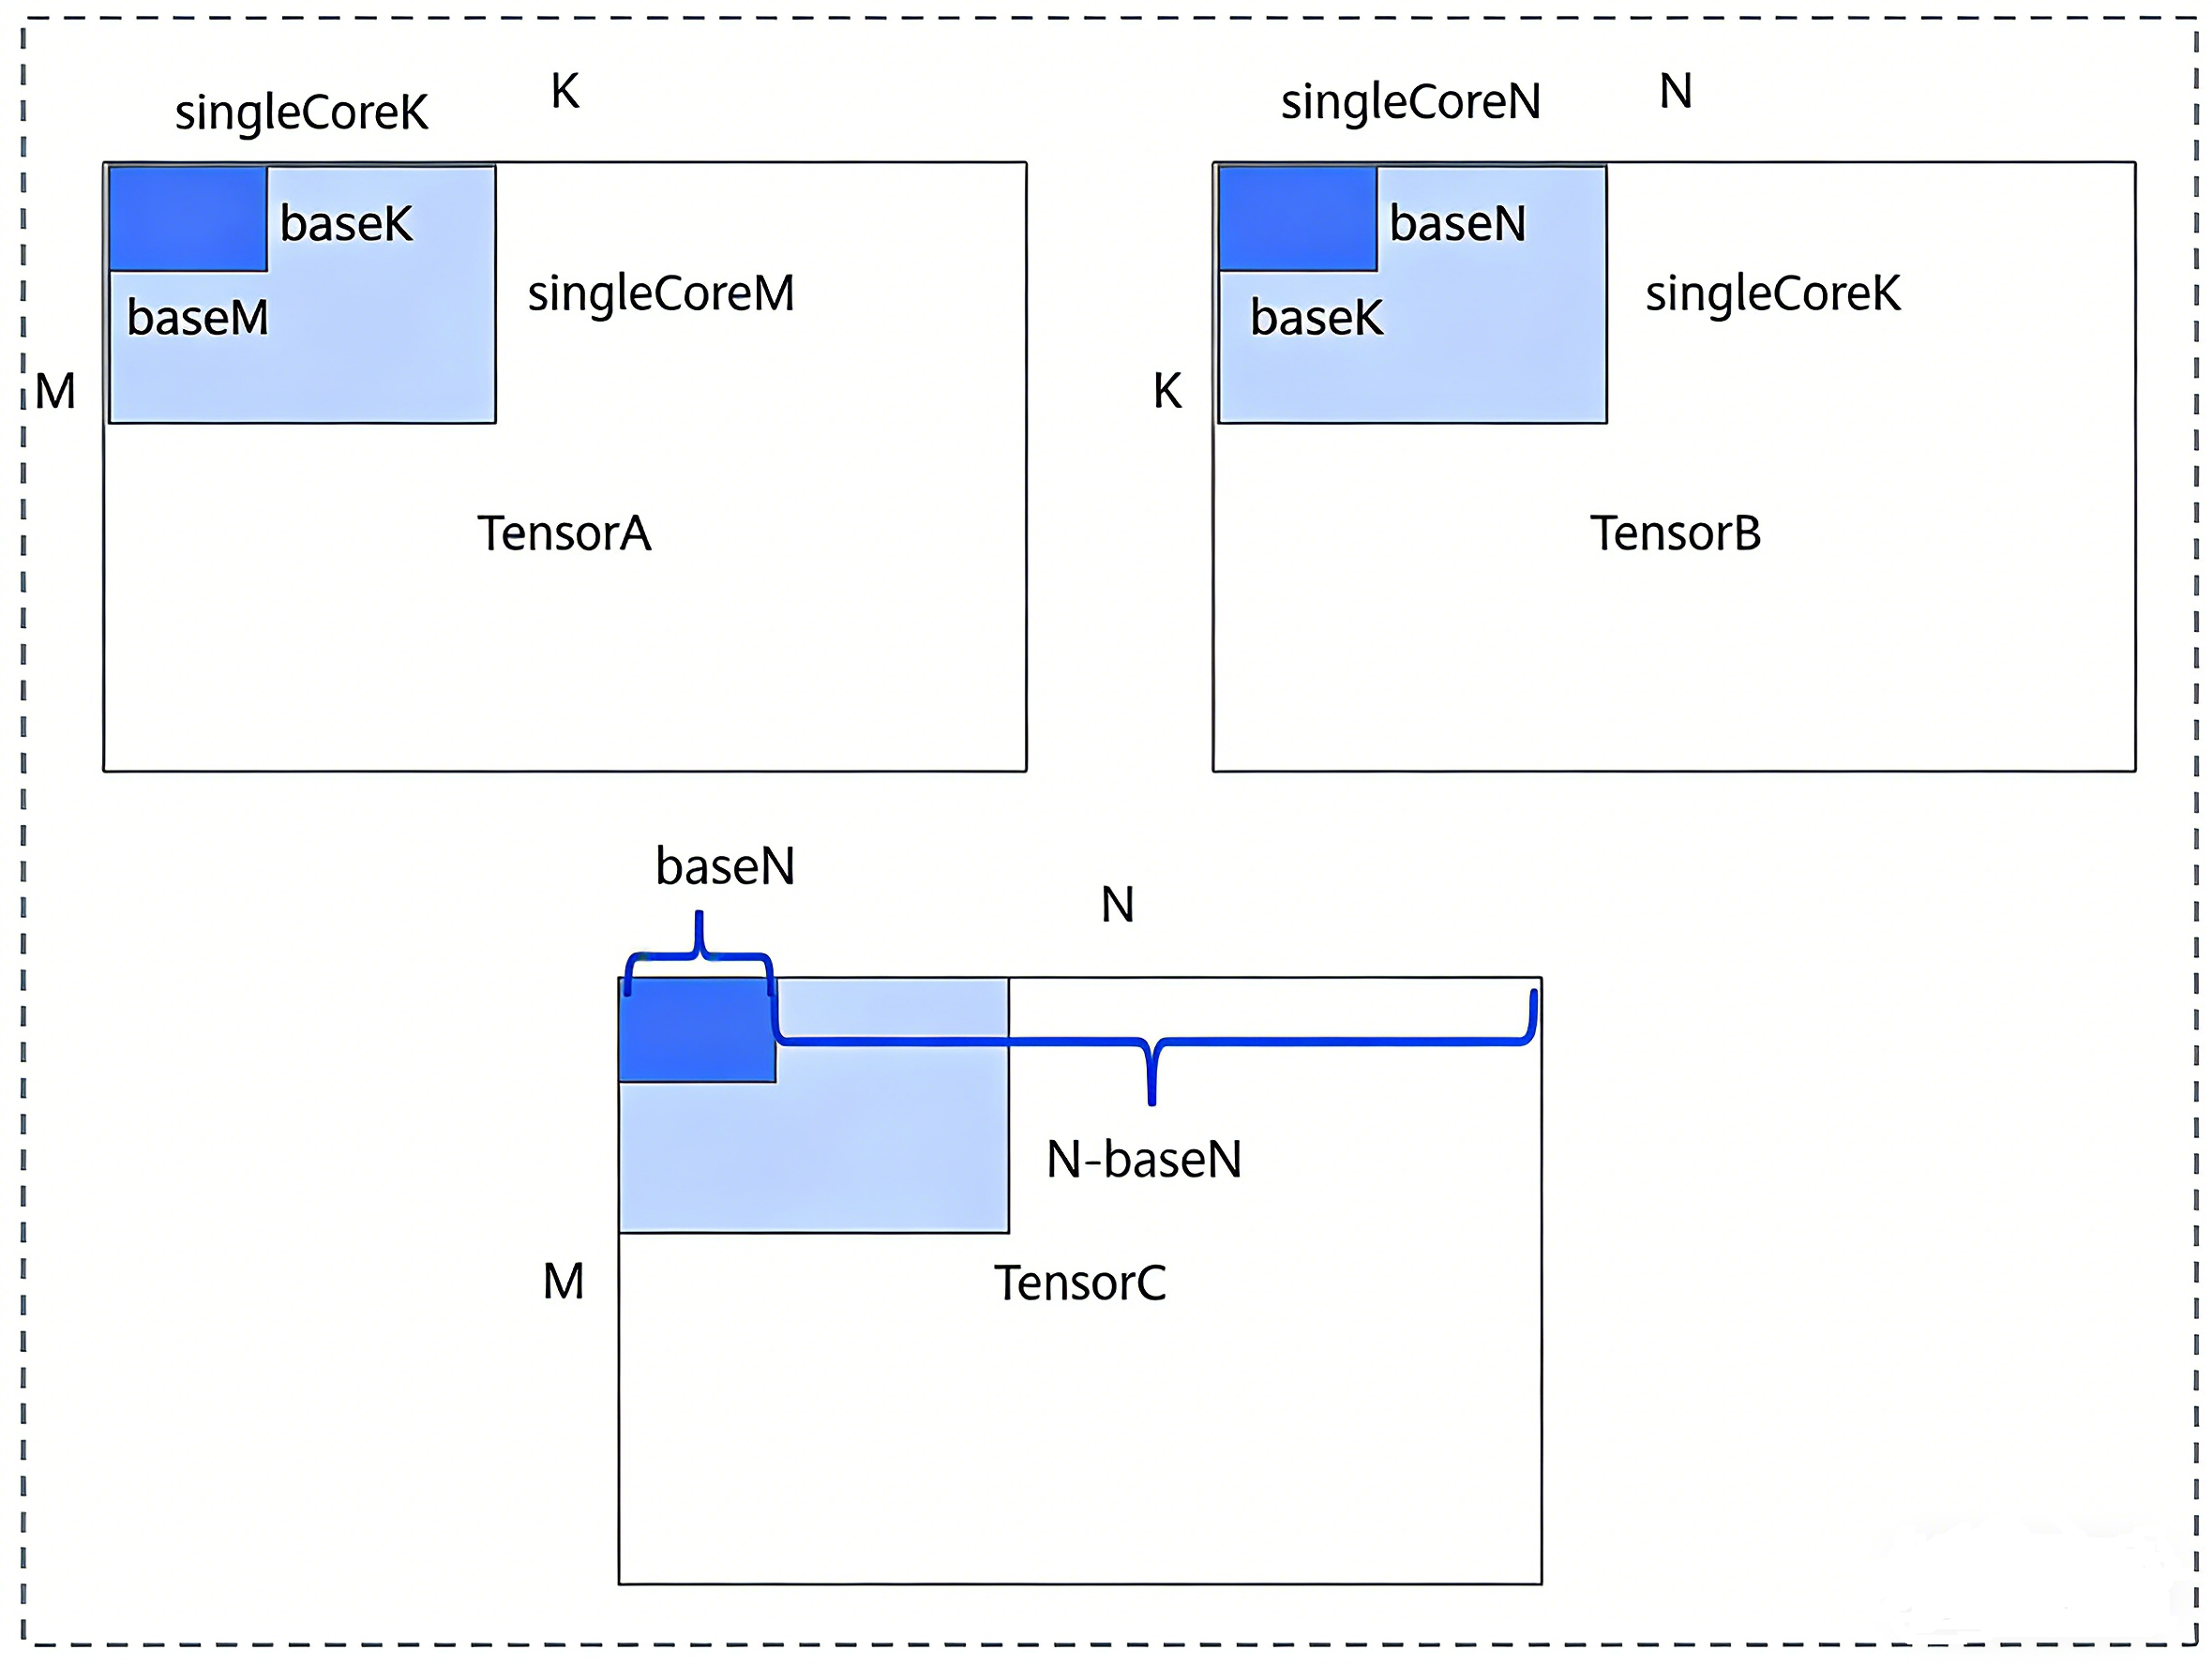
DataCopyParams param = {
    blockCount = baseM,
    blockLen   = baseN * sizeof(T) / 32,
    srcStride  = 0,
    dstStride  = (N - baseN) * sizeof(T) / 32
};
DataCopy(cGlobal[startOffset], local, param);
具体单位应以 API 文档为准。课程示例使用 DEFAULT_C0_SIZE 换算为 DataBlock 数,不能把字节、元素和 DataBlock 混用。
Mix Kernel 入口
extern "C" __global__ __mix__(1, 2)
void matmul_leakyrelu_custom(
    GM_ADDR a, GM_ADDR b, GM_ADDR bias, GM_ADDR c,
    __gm__ uint8_t* __kfc_workspace__ workspace,
    TCubeTiling tiling)
{
    AscendC::TPipe pipe;
    MatmulLeakyKernel<half, half, float, float> op;
    op.Init(a, b, bias, c, tiling, 0.001f, &pipe);
    REGIST_MATMUL_OBJ(&pipe, GetSysWorkSpacePtr(),
                      op.matmulObj, &op.tiling);
    op.Process();
}
__kfc_workspace__ 让编译器和 Matmul 高阶 API 协调系统 workspace。
三种 Vector 后处理
LeakyReLU
可使用高阶 LeakyRelu API。测试必须包含负值,否则只能验证正分支。
Abs
结构与 LeakyReLU 基本相同,只需把 Vector 计算替换为 AscendC::Abs。课程练习使用负的 Matmul 结果,可有效验证绝对值分支。
Sinh
若没有直接 Sinh 指令,可组合:
positive = exp(x)
negative = exp(-x)
output   = (positive - negative) × 0.5
它比 LeakyReLU/Abs 需要更多中间结果,通常要用 TBuf<VECCALC> 申请临时 Tensor,并把其容量计入 UB 预算。
测试设计
课程 LeakyReLU 样例得到 512.5,所有值为正,因此并未覆盖负半轴。更完整的测试应包括:
- 正值、负值和零;
- M/N 不是 baseM/baseN 整倍数的尾块;
- 不同 dtype;
- 多个核的不同 M/N 分区;
- 极端输入下 Sinh 的溢出风险;
- 与 CPU Golden 的
atol/rtol比较。
Sinh 练习使用 a=0.125、b=0.0625、K=512、Bias=0.5:
A×B+Bias = 0.125 × 0.0625 × 512 + 0.5 = 4.5
sinh(4.5) ≈ 45.003
使用误差阈值验证比严格相等更合理。
常见误区
- Matmul 输出仍配置为 GM。 融合 Vector 消费时应配置为合适的 Local/VECIN 位置。
- 结果 Tile 可一次连续写回。 全局矩阵行跨度为 N,需要二维搬运参数。
- 偏移只看 blockIdx。 还要结合 M/N 分块数量与遍历顺序。
- LeakyReLU 正数样例足以验证功能。 必须覆盖负分支和 alpha。
- 替换激活 API 就完成 Sinh。 多步函数还需要临时缓冲、UB 预算和数值稳定性验证。
一句话总结
CV 融合实现的关键是让 Matmul 的结果 Tile 直接落到 Vector 可读的 LocalTensor,并用正确的分块偏移和二维 CopyOut 写回全局矩阵。
复习卡片
- 输出位置:Matmul C 配置为 VECIN。
- 入口:
__mix__(cube, vec)。 - 流程:Iterate → GetTensorC → Vector API → CopyOut。
- 核偏移:M/N 分块索引。
- 写回:按行带目标 stride。
- 复杂激活:需要 TBuf 和额外 UB。
自测问题
- 为什么融合 Matmul 的输出类型位置要设为 VECIN?
mCoreIdx和nCoreIdx如何由 blockIdx 得到?- 为什么结果 Tile 写回 C 时需要
dstStride? - Sinh 相比 Abs 为什么需要更多片上内存?
参考答案
- 让 Matmul 结果直接成为 Vector 流水线可消费的局部数据,避免 GM 往返。
- M 优先时,分别是
blockIdx % mBlocks与blockIdx / mBlocks。 - Local Tile 每行只有 baseN 个元素,而全局 C 每行有 N 个元素。
- Sinh 由多步 Exp、取负、减法和缩放组成,需要保存中间 Tensor。
图片来源
本文图片取自 3day 课程原图及以下 CANN Learning Hub 课程: