学习目标
这篇笔记用于建立 Ascend C 程序最小闭环:在 Device 侧编写核函数,在 Host 侧创建运行资源并启动核函数。学完后应能解释核函数声明、<<<...>>> 启动参数、block_idx 的作用,以及 Hello World 程序的完整生命周期。
先修知识
- C/C++ 函数、指针与宏
- Host、Device、AI Core 和 Global Memory
- Linux 命令行与 CMake 基础
核函数是什么
核函数(Kernel Function)是 Ascend C 设备侧程序的入口,也是 Host 侧代码与 NPU 计算逻辑之间的桥梁。Host 通过扩展启动语法将任务放入 Stream,运行时再把任务调度到可用的 AI Core 上执行。
课程给出的核函数声明结构如下:
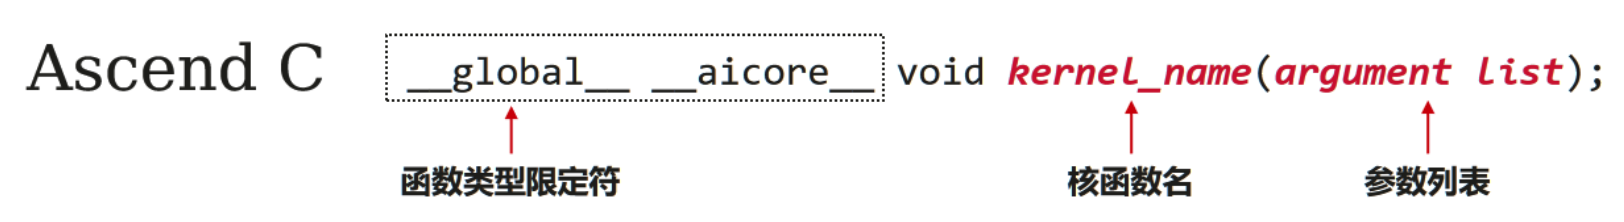
最小形式:
__global__ __vector__ void hello_world()
{
    AscendC::printf("Hello World!\n");
}
函数限定符
| 限定符 | 作用 |
|---|---|
__global__ | 声明这是可由 <<<...>>> 启动的核函数 |
__aicore__ | 在 AI Core 上执行,由编译器根据指令识别核类型 |
__vector__ | 明确在 Vector 核上执行 |
__cube__ | 明确在 Cube 核上执行 |
__mix__(cube, vec) | 表示同时涉及 Cube 与 Vector 的混合核函数 |
如果函数只有 Scalar 控制逻辑,编译器可能无法根据 Vector/Cube 指令推断核类型,此时需要显式指定执行空间。
返回值与参数
- 核函数返回类型必须是
void; - 参数可使用基础类型、由基础类型组成的结构体及指针;
- 指向 Global Memory 的指针需要使用
__gm__限定; - 常用
GM_ADDR简化统一地址参数:
#define GM_ADDR __gm__ uint8_t* __restrict__实际计算前,再把字节指针转换成所需的数据类型。
Host—Device 协同
Host 侧主要负责设备、内存、Context 和 Stream 等运行时资源;Device 侧执行计算密集型 Kernel。任务被放入 Stream 后,由运行时调度到空闲 AI Core。
Host 准备任务 → 任务进入 Stream → 调度到 AI Core → Kernel 执行SPMD 多核并行
Ascend C 使用 SPMD(Single Program, Multiple Data)模型:多核运行同一份程序,但每个核处理不同的数据分片。
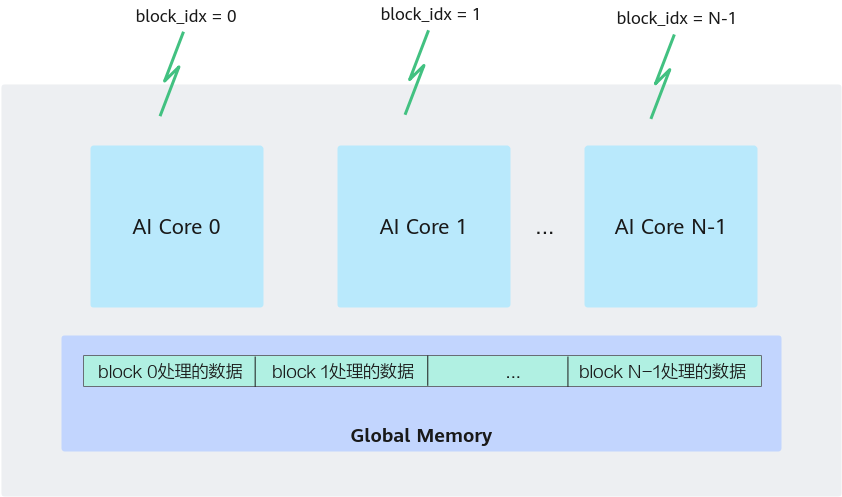
每个核通过逻辑索引区分自己的数据范围:
uint32_t blockId = AscendC::GetBlockIdx();
uint32_t blockNum = AscendC::GetBlockNum();
假设总元素数为 totalLength,且能够被核数整除:
blockLength = totalLength / blockNum
本核起点     = blockLength × blockId
这只是最简单的均分方案。若不能整除,就需要尾核处理或泛化 Tiling,不能直接丢弃余数。
核函数启动语法
kernel_name<<<numBlocks, l2ctrl, stream>>>(arguments...);| 参数 | 含义 |
|---|---|
numBlocks | 启动多少个逻辑核实例 |
l2ctrl | 当前课程中使用 nullptr |
stream | 承载异步任务的 AscendCL Stream |
numBlocks 决定 GetBlockNum(),各实例的索引范围为 0 到 numBlocks - 1。
Hello World 完整流程
Host 侧调用一个不含输入输出的 Kernel,需要:
aclInit初始化 AscendCL;aclrtSetDevice设置设备;aclrtCreateStream创建 Stream;- 使用
<<<...>>>启动核函数; aclrtSynchronizeStream等待任务完成;- 销毁 Stream、重置设备并
aclFinalize。
课程原图给出了带数据场景下更完整的调用顺序:
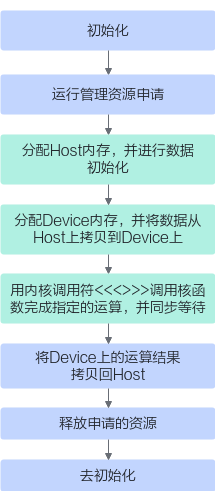
核心代码:
int main()
{
    aclInit(nullptr);
    int32_t deviceId = 0;
    aclrtSetDevice(deviceId);

    aclrtStream stream = nullptr;
    aclrtCreateStream(&stream);

    constexpr uint32_t numBlocks = 8;
    hello_world<<<numBlocks, nullptr, stream>>>();
    aclrtSynchronizeStream(stream);

    aclrtDestroyStream(stream);
    aclrtResetDevice(deviceId);
    aclFinalize();
    return 0;
}
编译
使用毕昇编译器时必须让目标架构与 NPU 匹配:
bisheng hello_world.asc --npu-arch=dav-2201 -o demo
./demo
dav-2201 是课程环境示例,不应无条件复制到其他型号。开始项目前应先查询实际芯片和当前 CANN 版本支持的架构值。
常见误区
- 核函数像普通函数一样直接调用。 核函数需要通过
<<<...>>>指定核数和 Stream。 - 启动多个核会自动切分数据。 运行时启动多个实例,但数据偏移仍需开发者或 Tiling 逻辑计算。
- Kernel 启动后结果立即可用。 Stream 是异步队列,Host 使用结果前需要正确同步。
- 总长度一定能被核数整除。 固定样例可以这样假设,泛化实现必须处理余数。
- 目标架构参数可以照抄。
--npu-arch必须匹配实际环境。
一句话总结
Ascend C 核函数由 Host 通过 Stream 启动,并以 SPMD 方式在多个 AI Core 上执行同一份程序、处理不同数据分片。
复习卡片
- Device 入口:带
__global__的核函数。 - 核类型:
__vector__、__cube__、__aicore__等。 - 多核模型:SPMD。
- 核身份:
GetBlockIdx()。 - 启动配置:
<<<numBlocks, nullptr, stream>>>。 - Host 生命周期:初始化 → 创建资源 → 启动 → 同步 → 释放。
自测问题
__global__与__vector__分别说明什么?- SPMD 中不同核如何区分自己处理的数据?
- 为什么启动 Kernel 后通常需要同步 Stream?
- 当总长度不能被核数整除时,简单的均分公式有什么问题?
参考答案
- 前者声明可由 Host 启动的核函数,后者指定该核函数在 Vector 核上执行。
- 通过
GetBlockIdx()获得逻辑核索引,再据此计算数据偏移。 - Kernel 启动是异步的,同步可保证任务完成后再读取结果或释放资源。
- 整数除法会留下余数,部分数据可能无人处理,需要尾核或泛化 Tiling。
图片来源
本文图片取自 CANN Learning Hub:Ascend C 的 Hello World,本地保存仅用于学习笔记。